Une démonstration IA peut convaincre avant même que l’équipe ait défini la valeur attendue, le responsable de production ou les défaillances acceptables. C’est ainsi que les pilotes s’enlisent.
Le pilote peut échouer avant même le modèle
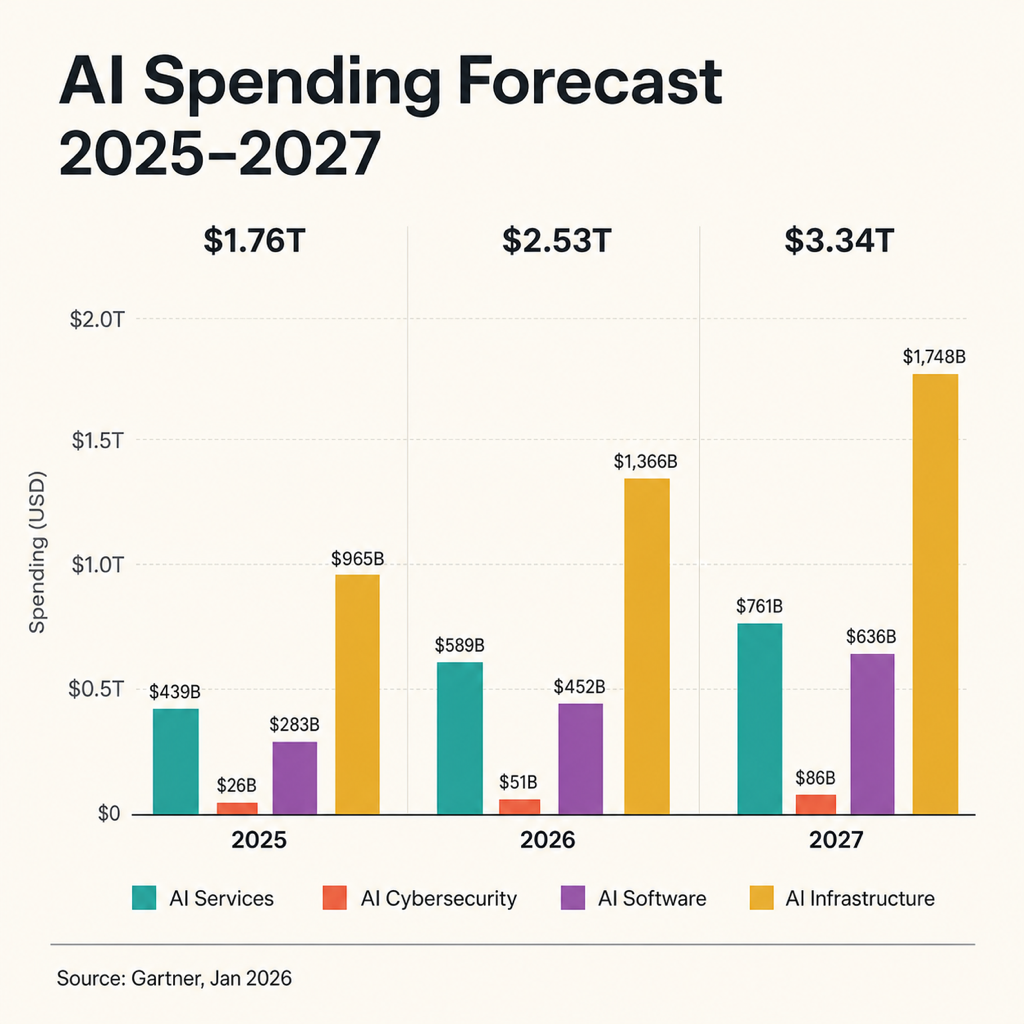
Depuis près de dix ans sur des plateformes de données en secteurs régulés, je retrouve le même ordre des opérations : le budget et l’activité technique arrivent avant la définition du travail à améliorer. Gartner prévoit 2 520 milliards de dollars de dépenses mondiales en IA en 2026. Ce chiffre mesure une dépense attendue, pas du travail utile.
Le résultat du MIT NANDA souvent cité indique que 95 % des pilotes d’IA générative ne produisent pas de retour sur investissement significatif. C’est un avertissement utile, pas un taux d’échec universel. Ce résultat porte sur le retour sur investissement significatif déclaré dans ce contexte de recherche ; il ne montre pas que 95 % de tous les pilotes échouent pour une cause technique commune.
Quatre mécanismes suffisent à expliquer beaucoup de pilotes bloqués : valeur indéfinie, contraintes de production contournées, exploitation sans responsable et démonstration mesurée à la place du travail. Architecture, sécurité, coût et compétences ne sont pas des sujets annexes ; ils rendent ces failles visibles.
Échec 1 : la valeur est un slogan, pas une unité de travail
Un pilote part mal lorsque son objectif consiste à « utiliser l’IA » ou à « améliorer la productivité ». Ce sont des ambitions, pas des résultats. Avant de choisir un modèle, nommez une décision ou une tâche récurrente, son niveau de départ, son responsable métier et le coût d’une erreur. L’unité peut être un dossier traité correctement, un document revu dans le délai prévu ou un passage de relais sans reprise. Elle doit rester observable dans le travail quotidien.
L’architecture vient après cette promesse. Un lakehouse combine stockage ouvert et gestion de type entrepôt ; un data mesh confie les produits de données aux équipes métier. Aucun ne corrige un cas d’usage vague. Ils servent seulement une tâche qui exige données fiables, responsabilité claire et traçabilité des réponses.
La génération augmentée par récupération (RAG) fournit des documents au moment de répondre. Un système agentique peut ensuite choisir sources et outils sur plusieurs étapes. Plus le parcours devient libre, plus la tâche, les sources autorisées et les tests de réussite doivent être bornés. Sinon, la démonstration est seulement plus élaborée.
| Couche opérationnelle | Question à trancher | Preuve de progrès | Responsable |
|---|---|---|---|
| Résultat métier | Quelle tâche récurrente change ? | Niveau de départ et seuil de réussite | Responsable du processus |
| Données et modèle | Quelles preuves le système peut-il utiliser ? | Sorties traçables et évaluées | Responsable données et technique |
| Exploitation | Qui gère l’échec et le changement ? | Procédure, niveau de service, escalade | Responsable de service identifié |
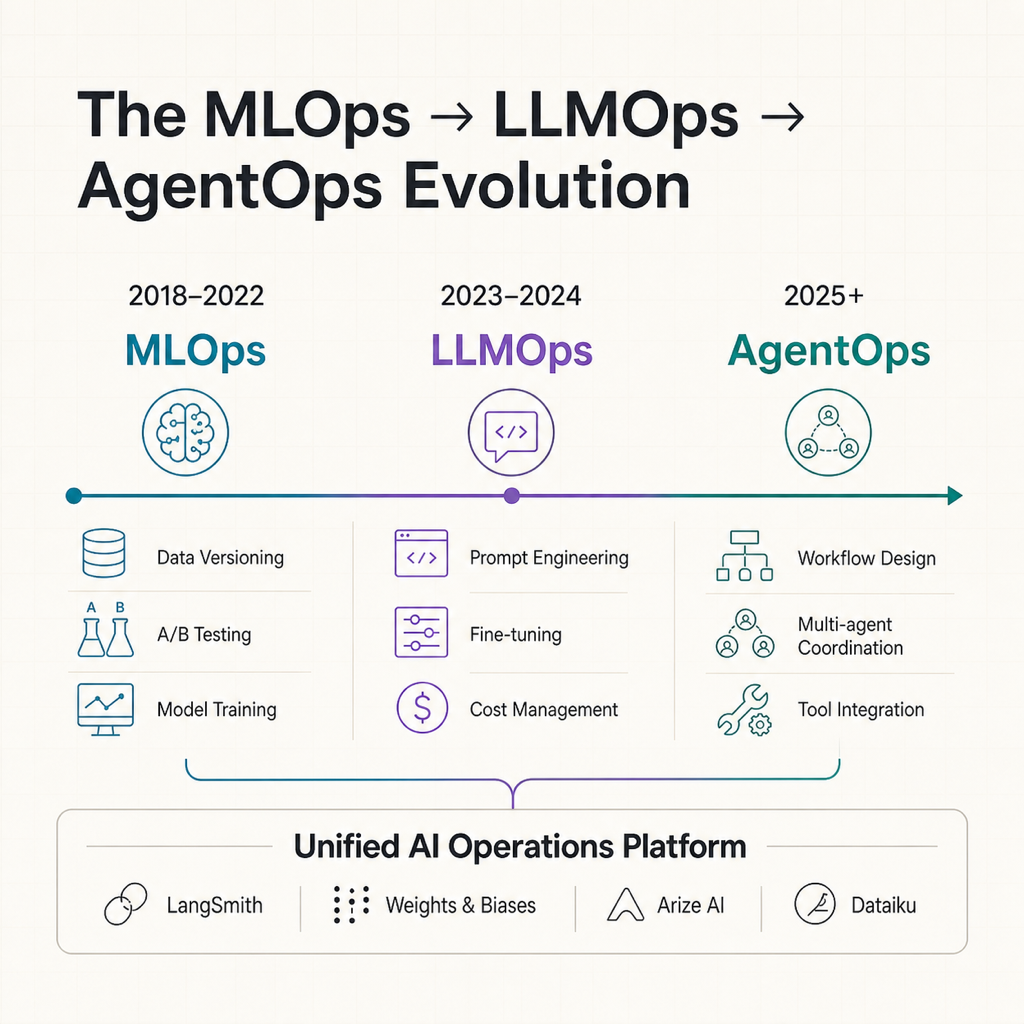
Les termes MLOps (exploitation des systèmes de machine learning), LLMOps (exploitation des applications fondées sur de grands modèles de langage) et AgentOps (exploitation de systèmes qui choisissent des outils et des étapes) désignent des préoccupations utiles. Ce ne sont pas des labels de maturité. Une équipe incapable de nommer son unité de valeur et son responsable ne sera pas sauvée par une plateforme supplémentaire.
Échec 2 : le prototype contourne les contraintes de production
Le coût des jetons varie avec la longueur des requêtes, la fenêtre de contexte, les nouvelles tentatives et le nombre d’étapes d’un agent. Mais le prototype masque souvent davantage : identité, qualité des sources, objectifs de latence, incidents et cas difficiles. Tout réapparaît dès que de vrais utilisateurs dépendent du système.
| Ce que la démonstration masque | Ce que la production exige | Défaillance révélée | Premier contrôle à mettre en place |
|---|---|---|---|
| Entrées propres et limitées | Données et droits représentatifs | Réponses peu fiables | Tester les cas normaux et défavorables |
| Une requête sur le chemin idéal | Nouvelles tentatives, solutions de repli et limites | Coût et latence dérivent | Fixer un budget par tâche terminée |
| Un humain devant l’écran | Journaux, alertes et support | Échecs invisibles | Écrire un circuit d’escalade |
| Aucune action externe | Accès aux outils au moindre privilège | Modification ou divulgation dangereuse | Revoir chaque action autorisée |
| Expérience courte | Contrôle du changement et évaluation | Qualité qui se dégrade sans être vue | Re-tester après un changement de modèle ou de données |
Les décisions d’infrastructure doivent donc découler de la demande mesurée, pas d’une prévision. Une API cloud convient souvent pour tester une tâche bornée. Une capacité dédiée ou hébergée par l’entreprise peut devenir pertinente à volume soutenu, mais seulement après avoir mesuré le travail accompli, la fiabilité et le coût complet d’exploitation. Une économie annoncée dans une simulation ne suffit pas à justifier chaque charge de travail.
Le FinOps appliqué à l’IA générative rend une personne responsable des coûts. Restez concret : consignez le coût, la latence et la qualité de la tâche qui compte. Ajustez les modèles et les requêtes, plafonnez les parcours coûteux et attribuez les exceptions. Le FinOps n’est pas un rapport financier isolé ; il évite qu’un problème économique se cache derrière un pilote technique.
Échec 3 : personne ne possède le système une fois qu’il agit
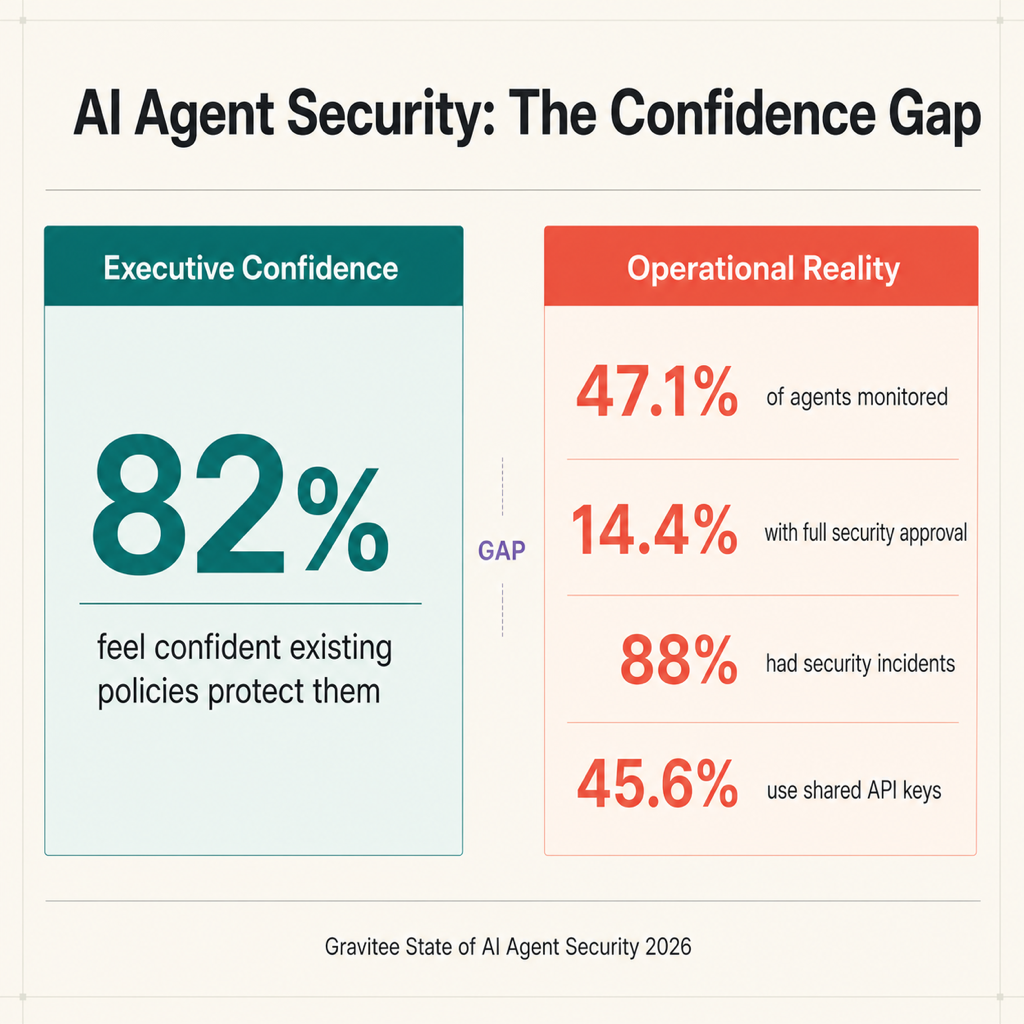
La question importante n’est pas de savoir si un agent est impressionnant. Il faut savoir qui répond de son comportement à 2 heures du matin, qui peut modifier ses autorisations et qui enquête après une action préjudiciable. L’enquête Gravitee citée auprès de dirigeants rapporte que 47,1 % des agents IA sont activement surveillés, alors que 82 % des dirigeants ont confiance dans leurs politiques. Une enquête éditeur n’est pas un audit du marché, mais cet écart est un avertissement opérationnel.
| Lacune de contrôle rapportée | Résultat de l’enquête | Pourquoi cela compte et première réponse |
|---|---|---|
| Surveillance active | 47,1 % | Les échecs peuvent ne laisser aucune trace. Journalisez requêtes, outils et résultats. |
| Approbation de sécurité complète | 14,4 % | Les contrôles peuvent suivre le déploiement au lieu de le précéder. Ajoutez une porte de mise en production. |
| Identités indépendantes | 21,9 % | Les actions ne sont pas attribuables clairement. Donnez à chaque agent une identité limitée. |
| Clés API partagées | 45,6 % | Les droits deviennent difficiles à retirer. Utilisez des accès éphémères au moindre privilège. |
| Incidents confirmés ou suspectés | 88 % | La catégorie est large et déclarative. Traitez ces incidents comme des signaux d’apprentissage, pas comme la preuve d’une intrusion. |
Un agent qui récupère des données, appelle des outils ou crée des enregistrements est un service qui prend des décisions. Il lui faut une identité limitée, le minimum de droits, une trace d’audit et un interrupteur d’arrêt. Ces contrôles servent d’abord à expliquer puis à interrompre une action.
Des cadres et des fonctionnalités éditeurs peuvent aider, mais ils ne fournissent pas de responsable. Que le système utilise un modèle managé, un lakehouse, du RAG ou un cadre d’agents, une personne doit répondre de ses données, de son comportement, de son coût et de ses décisions d’exploitation. Sans ce rôle, le pilote n’a pas de route crédible vers la production.
Échec 4 : la démonstration est mesurée, pas le travail
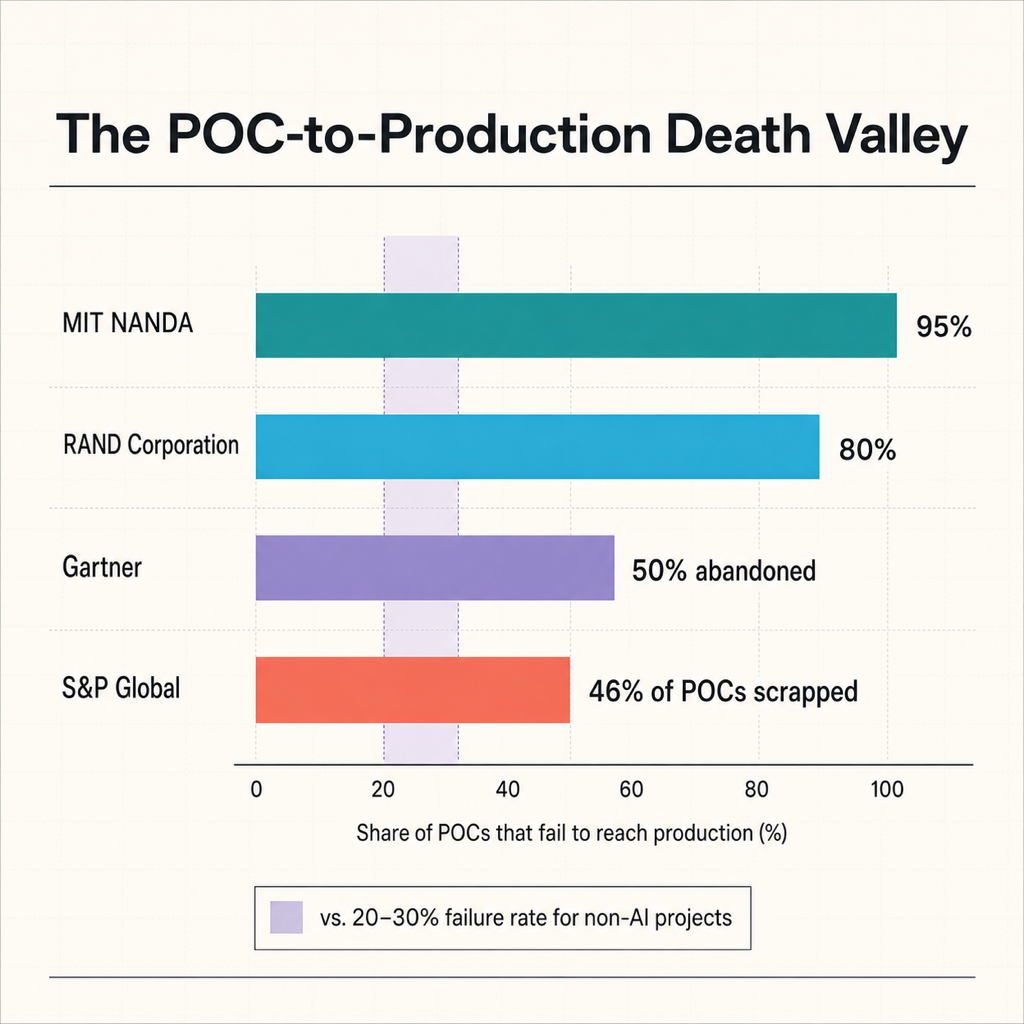
Une preuve de concept peut montrer qu’un modèle répond, retrouve un document ou réussit un parcours idéal. Elle ne montre pas qu’un processus réel s’est amélioré. Les chiffres d’échec publiés ci-dessous ne sont pas interchangeables : ils portent sur des populations, définitions et périodes différentes. Leur leçon commune est plus étroite et plus utile : une démonstration sans mesure de succès continue est facile à célébrer et difficile à exploiter.
| Source | Résultat rapporté | Ce que ce résultat ne démontre pas |
|---|---|---|
| MIT NANDA | 95 % sans retour sur investissement significatif | Un taux d’échec universel des pilotes |
| RAND Corporation | >80 % des projets IA échouent | Une cause unique commune à tous les projets |
| Gartner | Au moins 50 % abandonnés après la preuve de concept | Que l’abandon soit uniquement technique |
| S&P Global | 42 % ont abandonné la plupart de leurs initiatives | Que chaque initiative ait eu le même objectif |
Pour chaque pilote, définissez avant la démonstration un tableau de bord proche de la production : exécution correcte, taux d’exception, durée de cycle, reprise humaine, coût par tâche terminée et tout seuil de sécurité ou de conformité. Comparez-le ensuite au processus actuel. Si le système ne satisfait pas ces critères sur un travail représentatif, l’arrêter devient une décision, pas un manque d’enthousiasme.
Les quatre failles se rejoignent ici : sans valeur, aucun tableau de bord ; sans contraintes réelles, coûts et échecs restent cachés ; sans responsable, personne n’exploite le service. Une belle démonstration peut survivre à tout cela, jusqu’à la première dépendance réelle.
Les compétences comptent après avoir nommé le travail à exploiter
Les équipes ont besoin de personnes capables d’évaluer une sortie de modèle, de travailler avec des contrôles de données, de concevoir des intégrations sûres et d’exploiter un service. La formation seule ne définit pas le cas d’usage et ne désigne pas son responsable.
Formez les équipes au travail qu’elles devront exploiter : juger une sortie, savoir quand solliciter un responsable, retracer une décision, tester un changement de prompt ou de modèle avant sa mise en production et interpréter le tableau de bord. Ces tâches indiquent ce que développeurs et opérateurs ont besoin de pratiquer.
Traitez le prochain pilote comme un service à exploiter
Ne commencez pas par une feuille de route de plateforme. Partez d’un travail répété et coûteux, puis concevez le plus petit service capable de l’améliorer sans risque. Les étapes suivantes rendent les quatre mécanismes visibles tôt, lorsque l’arrêt ou le changement de cap coûte peu.
Immédiatement : nommez le responsable du processus, le niveau de départ, le seuil de réussite et la condition d’arrêt. Testez des cas représentatifs, y compris les exceptions. Consignez qualité, coût et temps par tâche terminée, pas seulement les requêtes ou les démonstrations.
Avant un usage élargi : ajoutez identité, accès au moindre privilège, journaux, évaluation, limites budgétaires et circuit d’escalade. Décidez qui répond des données, des changements de modèle, des incidents et du support utilisateur. Sans ces réponses, le pilote n’est pas prêt pour la production.
À l’échelle du portefeuille : financez la capacité d’exploitation autour des quelques tâches qui satisfont leur tableau de bord. Formez les équipes à ces flux de travail. Choisissez cloud, services managés et capacité dédiée à partir de la demande mesurée, de la fiabilité et du coût complet, non d’un schéma d’architecture IA générique.
Références
- Gartner. (2026). "Les dépenses IA mondiales atteindront 2 500 Mds$ en 2026."
- Estrada, S. (2025). "MIT : 95 % des pilotes GenAI échouent." Fortune.
- Ryseff, J., De Bruhl, B., et Newberry, S. J. (2024). "The Root Causes of Failure for Artificial Intelligence Projects and How They Can Succeed." RAND Corporation.
- Gravitee. (2026). "État de la sécurité des agents IA 2026."
- S&P Global Market Intelligence. (2025). "Generative AI experiences rapid adoption, but with mixed outcomes."
- Deloitte. (2026). "Tokens IA : dynamiques de dépenses."
- Chandrasekaran. (2026). "Pourquoi les projets GenAI échouent." Gartner.
- Deloitte. (2025). Enquête sur la valeur IA mesurable déclarée par les responsables financiers mondiaux.