La file de contrôle était devenue le goulot d’étranglement
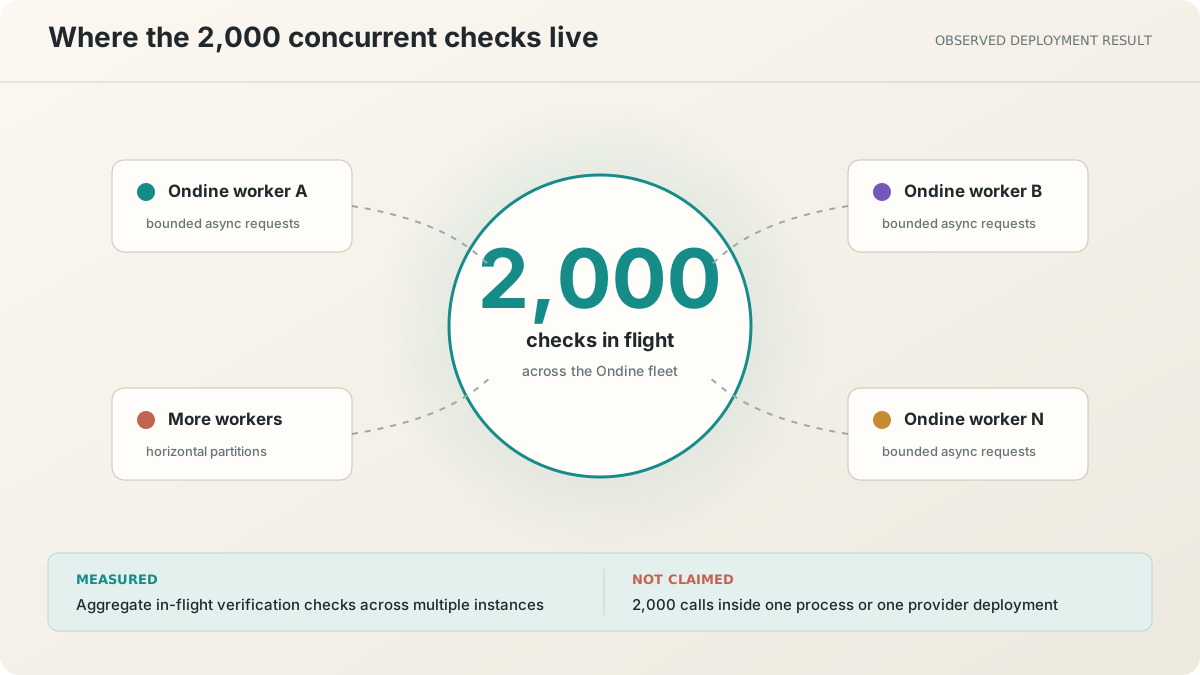
Ondine a réparti 2 000 vérifications simultanées entre plusieurs instances
J’ai transformé la vérification de paires de produits en une opération de DataFrame typée et reprenable, puis réparti la charge entre plusieurs instances Ondine. Cette étude détaille l’architecture derrière les 2 000 contrôles simultanés, avec les pannes, les quotas et les limites que ce chiffre ne montre pas.
Les substitutions de produits s’accumulaient dans une file de vérification. Le système d’IA proposait un remplacement, mais chaque paire exigeait une décision rattachée aux éléments qui la justifiaient. Une boucle sur un DataFrame laissait à l’application la gestion du suivi et des reprises.
J’ai utilisé Ondine pour transformer ces contrôles en une opération typée et reprenable sur un DataFrame. La charge était répartie entre plusieurs instances Ondine. Chacune envoyait un nombre limité de requêtes asynchrones à Azure OpenAI par l’intermédiaire de LiteLLM. Le déploiement complet a exécuté 2 000 vérifications simultanées. Ce chiffre appartient au déploiement relaté ici ; la page ne contient pas les journaux nécessaires pour le reproduire. L’architecture ci-dessous décrit la gestion de l’identité des lignes, des reprises, des coûts et des résultats partiels.
D’une file de contrôle manuel à une vérification distribuée
| Problème initial | Les paires de produits proposées par l’IA attendaient une vérification humaine lente. |
|---|---|
| Unité de travail | Une ligne de DataFrame contenant les éléments nécessaires à un contrôle. |
| Mise en œuvre | Plusieurs instances Ondine, une exécution asynchrone bornée, LiteLLM et Azure OpenAI. |
| Échelle rapportée | 2 000 contrôles simultanés sur l’ensemble du déploiement, pas dans un seul processus Python. |
| Contrôles d’exécution | Sorties structurées, reprise par ligne, nouvelles tentatives adaptées au fournisseur et plafonds de dépense explicites. |
Une réponse reçue n’est pas encore une ligne terminée
Une requête de vérification prépare une consigne, appelle le modèle et analyse sa réponse. Sur un jeu de données complet, des appels peuvent expirer, des réponses échouer à la validation et des fournisseurs limiter les rafales. Une instance peut s’arrêter après des milliers d’appels réussis. Le résultat attendu reste un tableau filtrable, auditable et raccordé au catalogue source.
L’exécution asynchrone fait se chevaucher les requêtes ; elle ne conserve pas la liste des lignes à relancer. Une reprise exige aussi les résultats terminés, l’état des échecs et le coût cumulé. Ondine conserve ces informations dans la chaîne de traitement pour éviter de les reconstruire depuis les journaux après chaque interruption.
Traiter une consigne comme une transformation typée de DataFrame
Chaque ligne contenait une paire de produits et les éléments à examiner. La consigne produisait trois colonnes : une décision, un niveau de confiance et une justification. Garder cette opération dans le DataFrame rendait explicite le lien entre l’entrée et le résultat.
from pydantic import BaseModel, Field

class Verification(BaseModel):
    is_equivalent: bool
    confidence: float = Field(ge=0, le=1)
    reason: str

# Forme conceptuelle : les colonnes d'entrée produisent des colonnes typées.
# proposed_product | reference_product | evidence
#        ↓ consigne Ondine + schéma Verification
# is_equivalent | confidence | reason
Pydantic vérifie la réponse par rapport au schéma. Une décision manquante ou un niveau de confiance hors limites échoue à la validation. Une réponse valide peut pourtant contenir une décision erronée : ni le schéma ni un nombre compris entre zéro et un ne prouvent l’équivalence de deux produits.
Les analystes peuvent examiner les colonnes produites à côté des éléments sources, puis approuver, refuser ou confier la substitution à un humain. La construction des consignes, les appels au fournisseur et la validation restent dans le même flux de données.
Le processus unique n’était pas l’unité de mise à l’échelle
J’ai réparti les données entre plusieurs instances Ondine. Chaque instance gérait un nombre borné de requêtes asynchrones. LiteLLM fournissait une interface commune vers les modèles servis par Azure OpenAI. Chaque résultat conservait l’identité de sa ligne, même lorsque les réponses arrivaient dans le désordre.
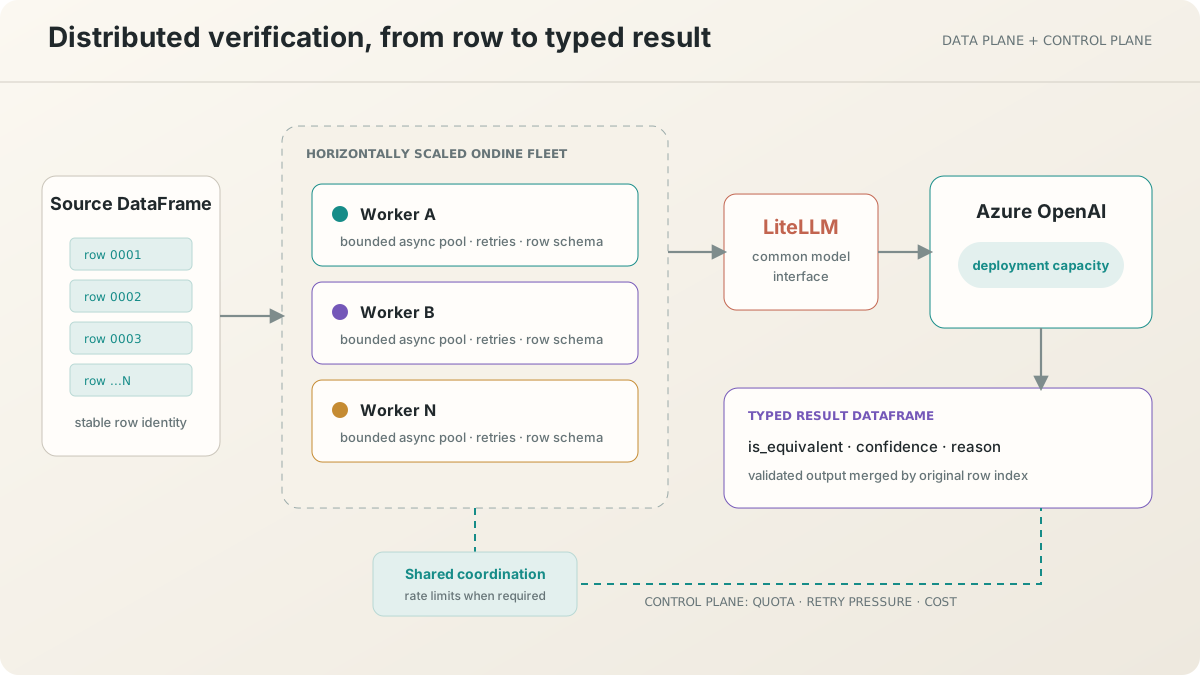
Le partitionnement répartissait la charge au-delà d’un processus Python tout en conservant un plafond de concurrence par instance. Les 2 000 contrôles rapportés décrivent leur activité cumulée. Ils ne donnent pas le bon réglage pour un autre modèle, un autre quota ou une autre taille de requête.
Une concurrence illimitée ne fait que déplacer la file d’attente
HTTP 429 signale qu’il faut réduire la pression, pas ajouter des tâches à la file. Chaque instance possède un plafond de concurrence. Ondine tient compte de l’indication Retry-After ; son limiteur adaptatif peut réduire la concurrence après une limitation, puis la relever lorsque les appels réussissent. Ce sont des capacités d’exécution, pas des mesures des réglages employés dans ce déploiement.
Dix instances raisonnables, prises séparément, peuvent dépasser un quota partagé. Ondine propose une limitation distribuée appuyée sur Redis ; les instances qui partagent un quota doivent utiliser le même périmètre de limitation. Une panne Redis peut déclencher un repli vers des limites locales, qui ne coordonnent plus l’ensemble. L’existence de cette option ne prouve pas son utilisation dans la topologie de production relatée ici.
| Contrôle | Ce qu’il protège | Ce qu’il ne garantit pas seul |
|---|---|---|
| Sémaphore de l’instance | Empêche un processus de produire une rafale illimitée | Le respect d’un quota partagé entre processus |
| Reprise avec temporisation | Absorbe les incidents temporaires du réseau ou du fournisseur | La correction d’une entrée définitivement invalide |
| Concurrence adaptative | Ajuste le débit à la capacité du fournisseur | Une répartition équitable entre toutes les instances |
| Limiteur distribué | Partage un budget de requêtes entre plusieurs instances | La qualité du modèle ou la validité des sorties |
La panne d’une instance ne doit pas effacer les contrôles terminés
import os
from uuid import UUID
from ondine import PipelineBuilder
from pydantic import BaseModel, Field

class Verification(BaseModel):
    is_equivalent: bool
    confidence: float = Field(ge=0, le=1)
    reason: str

pipeline = (
    PipelineBuilder.create()
    .from_dataframe(
        df_in,
        input_columns=["proposed_product", "reference_product", "evidence"],
        output_columns=["is_equivalent", "confidence", "reason"],
    )
    .with_prompt(
        "Compare {proposed_product} with {reference_product}. "
        "Use only this evidence: {evidence}"
    )
    .with_llm(
        provider="azure_openai",
        model="<base-model>",
        azure_endpoint=os.environ["AZURE_OPENAI_ENDPOINT"],
        azure_deployment=os.environ["AZURE_OPENAI_DEPLOYMENT"],
        use_managed_identity=True,
    )
    .with_structured_output(Verification)
    .with_concurrency(20)  # Par instance, à régler selon le quota.
    .with_checkpoint_dir(".checkpoints")
    .with_checkpoint_interval(100)
    .with_max_budget(50.0)
    .build()
)
result = pipeline.execute()

# Après un arrêt, reprendre avec l'identifiant de session affiché.
result = pipeline.execute(resume_from=UUID("<session-uuid>"))
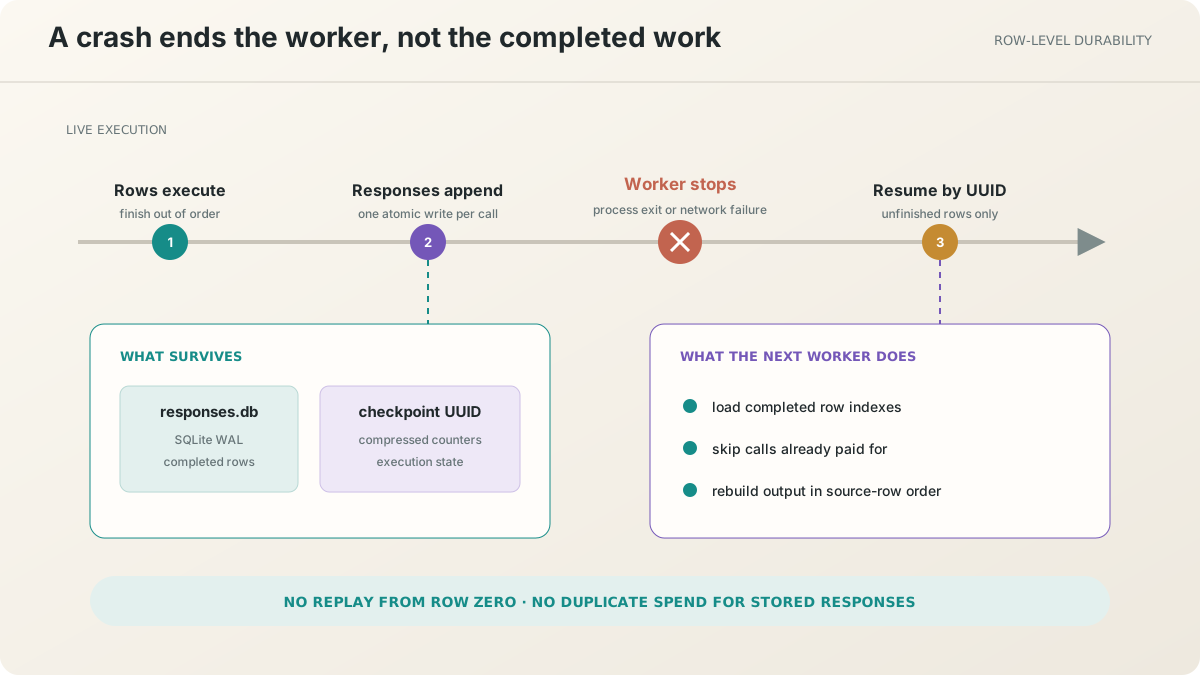
Ondine conserve les compteurs d’exécution dans des points de reprise compressés et les réponses terminées dans SQLite. La base utilise le mode WAL : chaque appel achevé est ajouté indépendamment. Si le processus s’arrête, les lignes déjà écrites restent disponibles. L’identifiant de session permet à execute de reprendre le travail restant en ignorant les réponses stockées. Une réponse facturée par le fournisseur, mais perdue avant son enregistrement, peut encore être redemandée et facturée lors d’une reprise.
Les instances terminent naturellement dans le désordre. Le stockage conserve donc l’index d’origine pour reconstruire le DataFrame dans le bon ordre. Les lignes en échec peuvent être rejouées séparément, sans relancer toute une partition réussie.
Le coût appartient au jeu de données complet
L’estimation de coût doit couvrir le jeu de données, pas une seule consigne. Les reprises et erreurs de validation peuvent ajouter des appels facturables. Ondine peut estimer la dépense avant exécution, suivre le coût déclaré par les réponses et arrêter une instance lorsque son seuil est franchi.
La limite doit donc laisser une marge pour les requêtes déjà en cours. L’exemple ci-dessus fixe un budget par instance ; il ne réserve ni ne contrôle un budget partagé entre toutes les instances.
Un total global peut masquer une partition bloquée
Un traitement distribué peut sembler sain alors qu’une partition subit des limitations répétées ou qu’une erreur de schéma consomme toutes ses reprises. La vue utile combine le débit global et le détail par instance : lignes terminées et en attente, requêtes en cours, taux de 429, reprises, latence, échecs de validation et coût cumulé.
Les libellés de métriques doivent rester bornés. Le fournisseur, le modèle, l’instance et l’état sont utiles ; les identifiants produit et les consignes brutes ne le sont pas. Ces valeurs à forte cardinalité coûtent cher et peuvent révéler des données métier. Le diagnostic par ligne appartient au stockage de reprise, relié à un identifiant d’exécution contrôlé.
Ce qui est rapporté et ce qui reste sans mesure publiée
| Rapporté dans cette étude | Non établi ici |
|---|---|
| La charge de vérification a été répartie entre plusieurs instances Ondine. | Un seul processus Ondine a soutenu 2 000 appels simultanés. |
| La flotte a atteint 2 000 contrôles simultanés via LiteLLM et Azure OpenAI. | 2 000 constitue une valeur sûre pour tout modèle, quota ou fournisseur. |
| Le traitement rattachait les résultats structurés aux lignes sources et permettait la reprise. | Une latence p95, un gain de précision ou une baisse de coût mesurés. |
| L’exécution horizontale a supprimé l’hypothèse d’une instance unique. | Augmenter la concurrence améliore toujours le débit. |
Cette page décrit l’architecture et fournit du code illustratif, pas un protocole de benchmark. Elle ne publie ni la durée de l’exécution, ni la configuration du modèle et des quotas, ni les traces brutes derrière le chiffre de concurrence. Ces éléments seraient nécessaires pour reproduire le résultat ou le comparer à un autre déploiement.
La prochaine limite se situe entre les instances
L’interface DataFrame donne à chaque contrôle une ligne d’entrée et une place pour son résultat. Les points de reprise préservent le travail stocké lorsqu’une instance s’arrête. Aucun de ces mécanismes ne décide, à lui seul, qui possède la prochaine partition ni quelle part d’un quota partagé lui revient.
C’est là que je poursuivrais le travail : réservation partagée des tâches, coordination des quotas fournisseur, budget global et vue d’exploitation reliant un échec à sa ligne source sans exposer la consigne dans les métriques. Ce sont des priorités de conception, pas des résultats supplémentaires revendiqués pour ce déploiement.