La clôture IFRS 17 durait sept heures Le cycle de provisionnement est passé à une heure
Les formules n’étaient pas le problème. Les événements sources tardifs, les jointures Spark déséquilibrées et les reprises dangereuses l’étaient. J’ai contribué à transformer le traitement de 200 millions de contrats en un cycle de production répétable d’une heure, sans perdre la piste d’audit.
200 M
Contrats
30+
Indicateurs
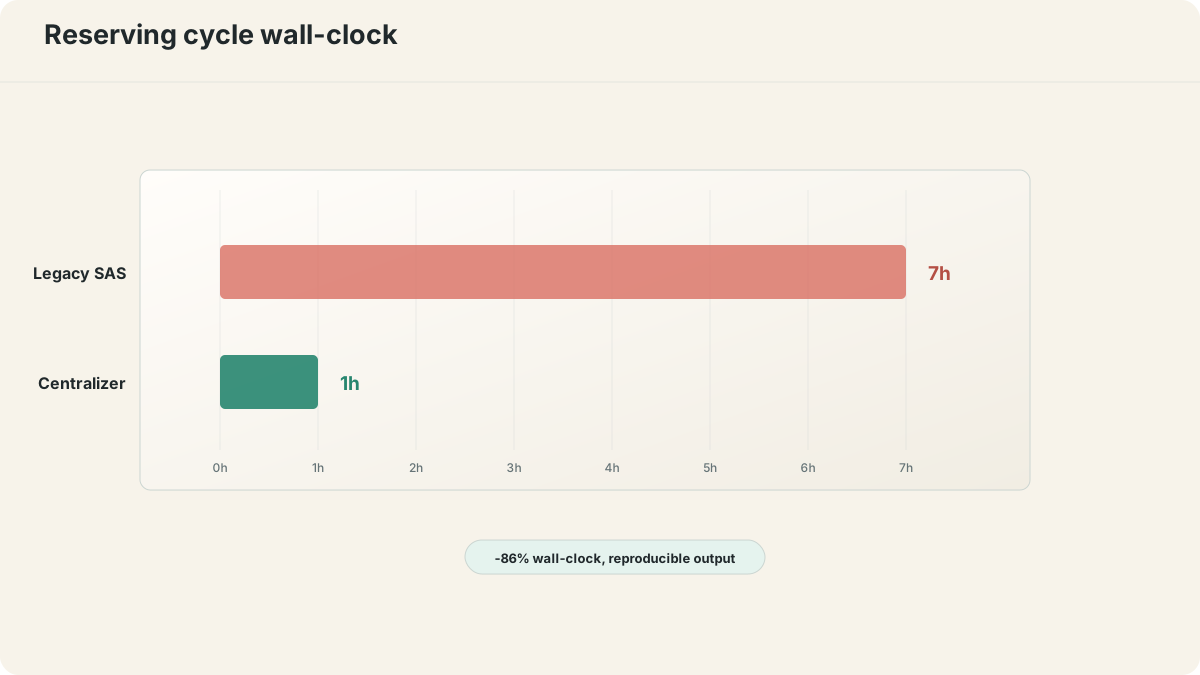
7 h → 1 h
Cycle de provisionnement
−40 %
Anomalies de données
Des événements sources arrivaient en retard. Un produit saturait une partition Spark. Les actuaires modifiaient leurs hypothèses pendant la clôture. Des dizaines de calculs dépendants devaient pourtant produire un résultat traçable et rejouable.
Comment lire cette étude : Les parties 0 à 2 expliquent le vocabulaire comptable du modèle de données. Leurs formules sont simplifiées : elles ne constituent pas une spécification comptable complète. La partie 3 décrit l'architecture ; la partie 4 suit les cinq problèmes de production et leurs corrections.
00 · EN BREF
Le projet en 90 secondes
Le provisionnement couvrait 200 millions de contrats. Lorsqu'une hypothèse changeait pendant la clôture, le résultat de remplacement devait apparaître de façon atomique et rester traçable jusqu'à ses entrées. Les durées et nombres d'incidents ci-dessous décrivent ce déploiement, pas un benchmark applicable à d'autres assureurs.
Plus de 50 traitements Spark partageaient une ingestion événementielle et des composants réutilisables. Nous avons mis en attente les événements désordonnés, évité la multiplication des lignes, réutilisé le partitionnement entre fenêtres de calcul, détecté les déséquilibres avant les jointures et publié les rejeux sous forme d'instantanés atomiques.
Échelle
200 millions de contrats et plus de 30 indicateurs actuariels.
Performance
Un cycle de provisionnement ramené de sept heures à une.
Fiabilité
Instantanés atomiques et retour à la version précédente pour isoler les rejeux des lecteurs.
Livraison
Les composants d’ingestion réutilisables ont ramené l’intégration de nouveaux cas actuariels de plusieurs semaines vers quelques jours.
Parcours conseillé : La limite non résolue se trouve en partie 8 : l'historique des instantanés et le retour arrière ne réglaient pas le changement d'hypothèses face à des données amont qui continuaient d'évoluer pendant la clôture.
RÉFÉRENCE · CONTEXTE
Pourquoi une règle comptable est devenue un problème de plateforme de données
Avant IFRS17, des assureurs pouvaient conserver des traitements comptables locaux différents pour des contrats comparables. Les résultats étaient donc difficiles à comparer entre pays et produits.
IFRS17, applicable depuis le 1er janvier 2023, demande d'estimer les flux de trésorerie futurs, de les actualiser avec des hypothèses courantes, d'ajouter un ajustement explicite pour l'incertitude et de reconnaître le profit à mesure que le service d'assurance est rendu. Les groupes déficitaires doivent être identifiés dès leur comptabilisation et la perte enregistrée immédiatement au résultat. Mettre cette règle en œuvre exige bien plus qu'un nouveau rapport : regroupement des contrats, historique des hypothèses, calculs rejouables, rapprochements et preuves traçables jusqu'aux données sources.
D’IFRS4 à IFRS17 : ce qui a réellement changé
Critère
IFRS4
IFRS17
Base d'évaluation
Différentes pratiques comptables locales pouvaient être maintenues.
Valeur actuelle des flux futurs ajustée du risque, complétée par le profit non acquis le cas échéant.
Taux d'actualisation
Le traitement dépendait de la pratique comptable conservée.
Évaluation courante ; le choix comptable relatif aux OCI affecte la présentation des produits et charges financiers d’assurance.
Reconnaissance du profit
Le calendrier dépendait de la pratique comptable conservée.
Profit reconnu à mesure que les services prévus au contrat sont rendus.
Contrats déficitaires
Perte reconnue uniquement si le test de suffisance des passifs échoue au niveau du portefeuille.
Test au niveau du groupe dès le premier jour ; perte au P&L immédiatement, pas de CSM.
Granularité
Portefeuille ou ligne de produit.
Cohortes annuelles × catégories de rentabilité ; aucun groupe ne couvre des contrats espacés de plus de 12 mois.
Information à fournir
Informations prescrites en complément des pratiques comptables conservées.
Rapprochements expliquant les variations des soldes de contrats et de leurs composantes d’évaluation.
J'ai vu un CFO comprendre, en pleine revue trimestrielle, que les deux tiers de son portefeuille étaient techniquement déficitaires sous la nouvelle norme. Il a blêmi. L'auditeur a souri.
01 · COMPOSANTES
Quatre valeurs pilotent le calcul
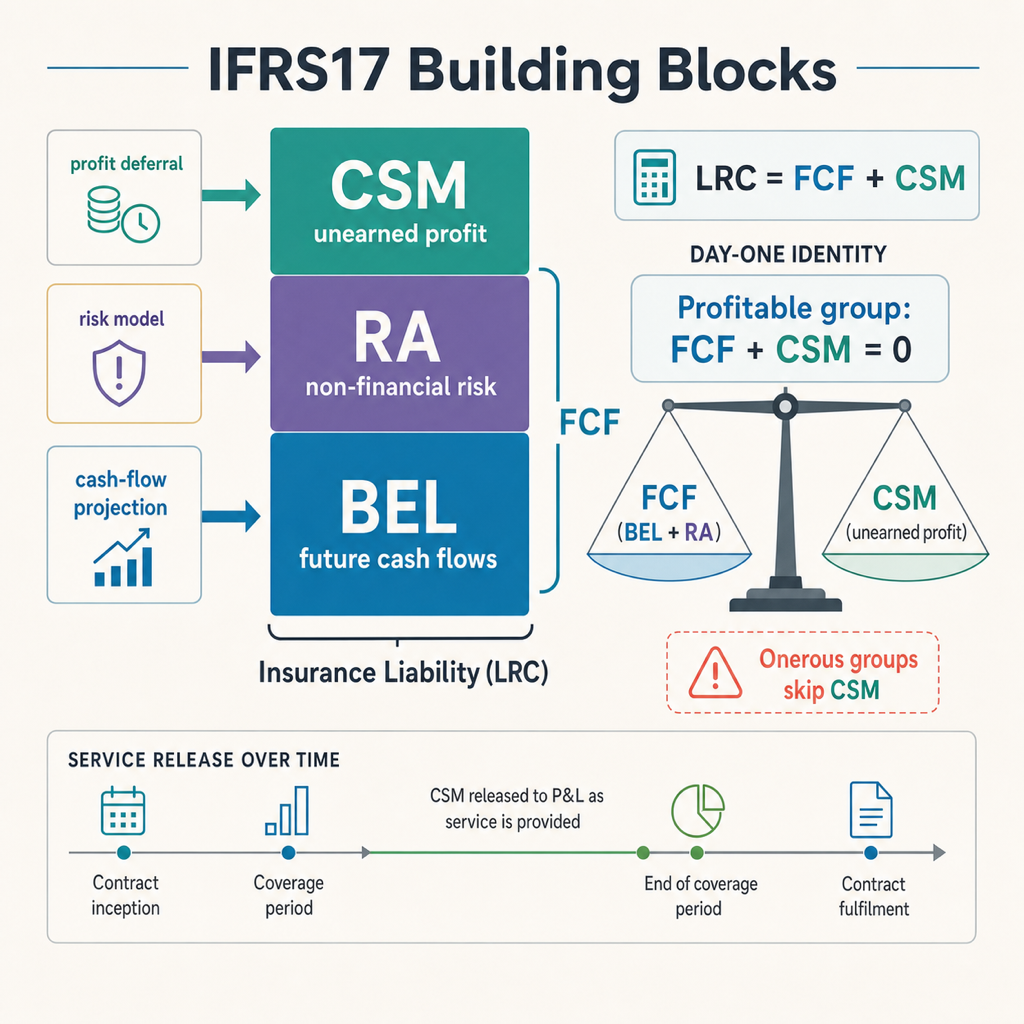
La plateforme recalcule quatre valeurs pour chaque groupe de contrats. L'estimation en valeur actuelle, appelée BEL dans cette implémentation, représente les flux attendus. Le RA ajoute l'incertitude non financière. Ensemble, ils forment les flux de trésorerie d'exécution. La CSM conserve le profit non encore acquis. À la comptabilisation initiale, un groupe rentable satisfait FCF + CSM = 0 selon la convention de signe utilisée ici, afin que le profit soit libéré pendant la période de service.
BEL Meilleure estimation des passifs
BEL = \sum_{t=1}^{T} \frac{E[CF_t]}{(1+r_t)^t}
Valeur actuelle, pondérée par les probabilités, de chaque flux de trésorerie futur : primes encaissées, sinistres versés, frais et rachats.
Le cœur du passif en valeur attendue. La marge de prudence n’y est pas intégrée ; elle relève du RA.
RA Ajustement pour risque
RA = \mathrm{VaR}_{\alpha}(L) - E[L] \quad \text{ou} \quad RA = \mathrm{CoC} \cdot \sum_{t} \frac{SCR_t}{(1+r_t)^t}
Compensation que l'assureur exige pour porter l'incertitude non financière (mortalité, rachat, frais).
Deux approches courantes sont présentées. IFRS17 fixe l'objectif et les informations à publier, pas une méthode de calcul unique.
FCF Flux de trésorerie d'exécution
FCF = BEL + RA
Obligation économique totale du groupe, avant tout profit non acquis.
Selon la convention de signe de cette implémentation, un FCF négatif indique un groupe rentable et un FCF positif un groupe déficitaire.
Profit non acquis, libéré pendant la période de couverture à mesure que le service est rendu.
Elle empêche la comptabilisation d’un gain dès le premier jour. Les groupes déficitaires n’ont pas de CSM : la perte est comptabilisée immédiatement.
SCHÉMALes composantes du passif d’assurance
La règle du jour un
FCF + CSM = 0
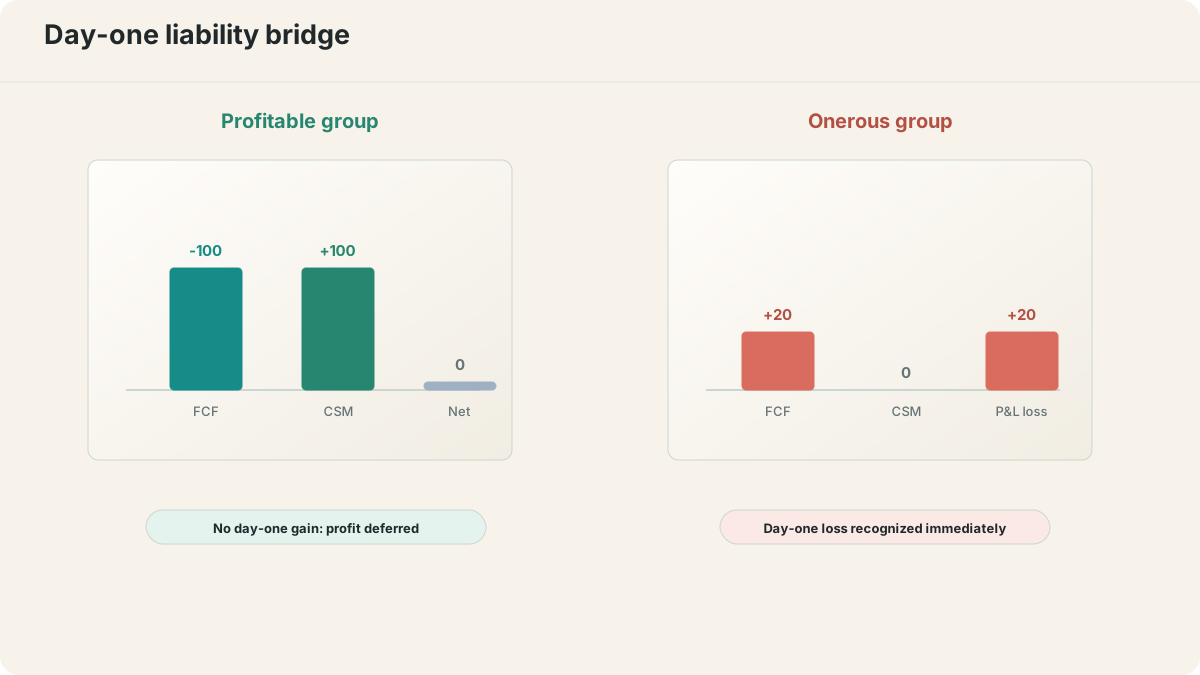
La première fois que j'ai expliqué cette règle à un actuaire senior, il m'a demandé si j'étais sûr. Deux fois. Dans l'exemple simplifié présenté ici, la CSM compense le FCF négatif pour ne pas reconnaître de profit non acquis à l'origine. Un FCF positif entraîne une perte initiale et aucune CSM. La perte passe au P&L ; une composante de perte dans la LRC en suit les mouvements ultérieurs. Le calcul complet tient aussi compte des flux à la date de comptabilisation initiale et des flux d'acquisition déjà comptabilisés, que l'équation ci-dessus laisse de côté.
GRAPHIQUEComptabilisation initiale : groupe rentable ou déficitaire
Tableau de variation de la CSM : comment évolue le profit non acquis
Ce terme concerne le GMM. Le VFA ajuste la part de l’assureur dans les variations de juste valeur des éléments sous-jacents et les flux d’exécution associés ; remplacer le taux par un taux courant ne modélise pas ces ajustements.
3
+ Affaires nouvelles
+\, CSM_0 \;\text{pour les nouveaux groupes rentables}
Seuls les nouveaux groupes rentables contribuent ; les groupes déficitaires sont comptabilisés directement au P&L.
4
± Changements d'estimations
\pm\, \Delta FCF_{\text{services futurs}}
Les hypothèses révisées sur les flux futurs ajustent la CSM. Les changements liés aux services passés vont au P&L.
5
− Amortissement
-\, CSM \cdot \frac{CU_t}{\sum_{r \ge t} CU_r}
Amortir avec les unités de couverture : capital_assuré × probabilité_de_survie pour la vie, polices en vigueur pour la non-vie.
Ce qui apparaît au bilan
Composante
Formule
Contenu
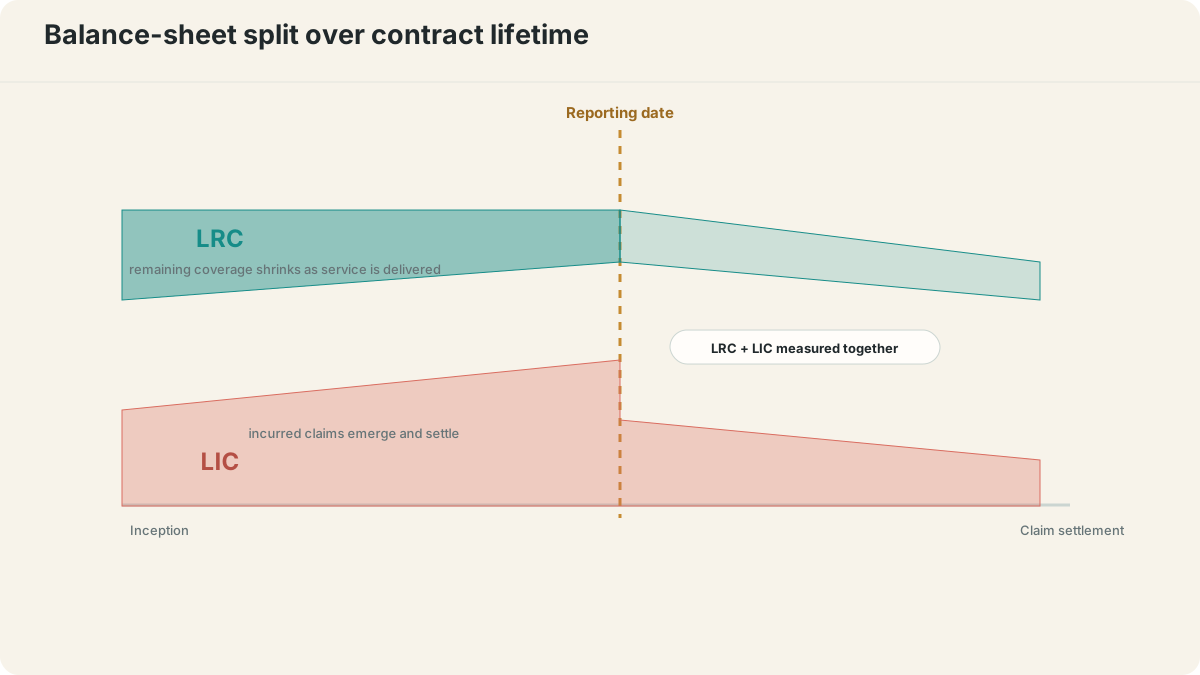
LRC : Passif au titre de la couverture restante
LRC = BEL_{RC} + RA_{RC} + CSM
Obligation de service futur. Sous le PAA, la mesure suit l'approche simplifiée de la norme ; elle ne se réduit pas en général à une ancienne formule UPR moins DAC.
LIC : Passif au titre des sinistres survenus
LIC = BEL_{IC} + RA_{IC}
Obligation de service passé. Inclut IBNR, IBNER et provisions dossier-dossier pour les événements déjà survenus.
Passif d'assurance total
\text{Total} = LRC + LIC
La ligne unique au bilan. Les deux composantes sont présentées séparément en annexes.
SCHÉMAÉvolution de la LRC et de la LIC pendant la vie du contrat
Trois modèles d’évaluation, selon le contrat
Caractéristique
Modèle général (GMM)
Honoraires variables (VFA)
Répartition des primes (PAA)
Applicability
All contracts (default)
Direct participation features
Short-term (optional)
Measurement
BEL + CSM + RA
GMM + variable fee adj.
Unearned premium reserve
Revenue
Over life, as risk released
Over life, as risk released
Over coverage period
02 · INDICATORS
Les huit indicateurs utilisés chaque jour par la plateforme
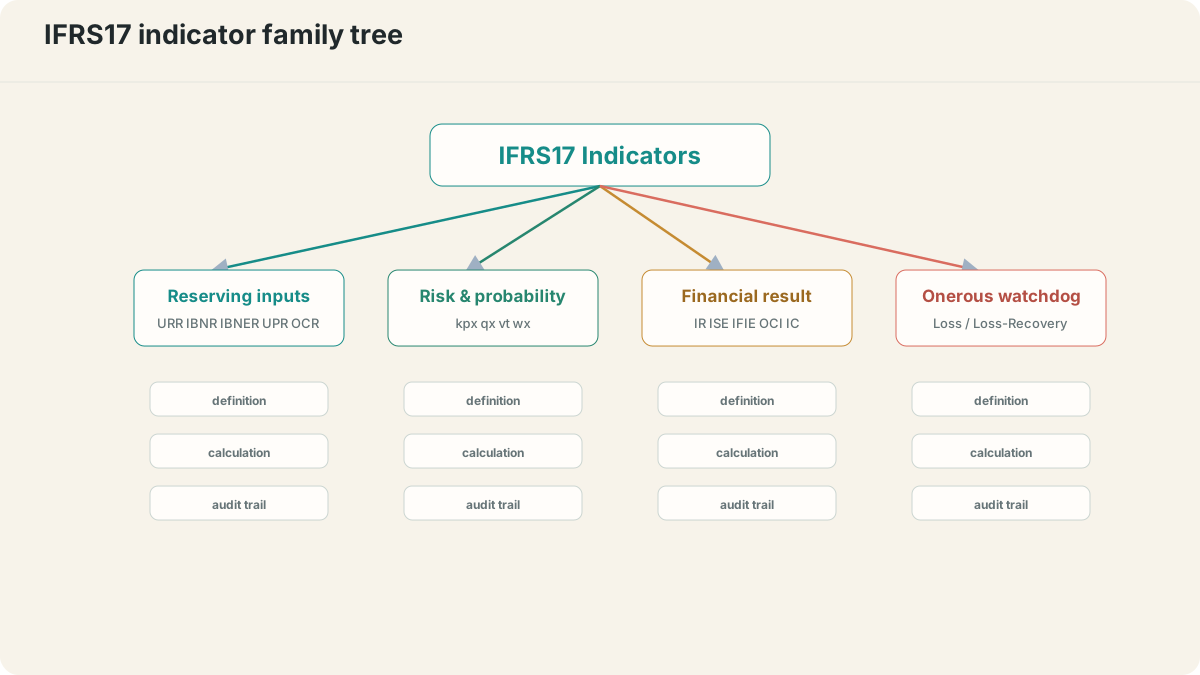
Plus de trente indicateurs alimentaient le reporting de production de cet assureur européen de premier rang. Ces huit indicateurs intervenaient dans les calculs quotidiens, répartis entre les trois familles qui alimentent le FCF, la CSM et le P&L. Le catalogue dépliable comprend les sensibilités, les ventilations et les sous-totaux d'annexes.
SCHÉMALes familles d’indicateurs IFRS17
Données de provisionnement (LIC + LRC)
URR
Provision pour risques en cours
URR = \max(UPR - DAC,\; UEC)
Constituée quand la prime non acquise est insuffisante pour couvrir les sinistres attendus sur la portion non écoulée. Pour les couvertures décès : VA(sinistres futurs) − VA(primes futures) si récurrent.
Portion prorata de la prime pour la part non écoulée de la durée du contrat.
PAA
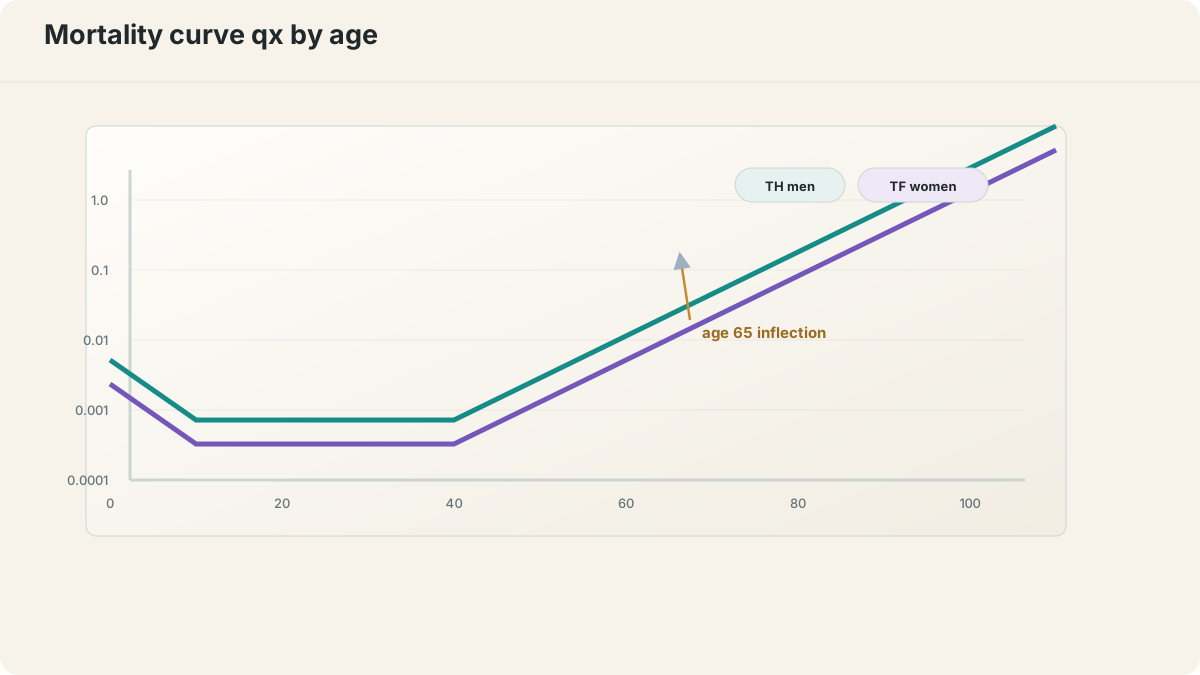
GRAPHIQUECourbe de mortalité qx selon les tables françaises TH et TF
Données de risque et de probabilité
kpx
Probabilité de survie
{}_{k}p_{x} = \prod_{t=0}^{k-1} (1 - q_{x+t})
Probabilité qu'une personne d'âge x survive les k années suivantes. Multiplie les taux de survie annuels.
qx
Taux de mortalité à l'âge x
q_x = \frac{d_x}{l_x}
Décès entre l'âge x et x+1 divisés par les vies exposées à x. Lu directement sur une table de mortalité.
vt
Facteur d'actualisation
v_t = \frac{1}{(1+r_t)^t}
Facteur d'actualisation à la période t avec la courbe des taux IFRS17. Pilote toutes les VA dans le BEL.
Indicateurs de résultat financier (P&L)
IR
Produits d'assurance
IR = \text{libération des composantes de service attendues} + \text{libération CSM} + \text{libération RA}
Décomposition illustrative de cette implémentation. IFRS17 définit le principe de reconnaissance et les informations à fournir, pas une formule universelle.
ISE
Charges d'assurance
ISE = \text{Sinistres survenus} + \text{Pertes sur déficitaires} + \text{Acq.Amort.} + \text{Autres}
Pendant de l'IR ; ensemble ils forment le résultat de service d'assurance.
Le reste du catalogue
Le reporting de production calcule aussi IBNER et OCR (provisionnement), Q(x+t|x) et wx (probabilité), IFIE, l'option OCI et IC (résultat financier). Ces indicateurs réutilisent les primitives de calcul de la plateforme. Leurs définitions détaillées ne sont pas nécessaires pour suivre l'architecture en partie 3.
Le contrôle des contrats déficitaires
Dans l'exemple simplifié de comptabilisation initiale, FCF > 0 identifie un groupe déficitaire. Il n'a pas de CSM ; la perte passe au P&L et est suivie par une composante de perte dans la LRC. Les améliorations admissibles des estimations de service futur réduisent cette composante avant de reconstituer une CSM. Les reprises de pertes sont exclues des produits d'assurance. La composante de recouvrement de perte concerne les contrats de réassurance détenus : elle ne désigne pas la reprise sur le groupe d'assurance sous-jacent.
03 · ARCHITECTURE
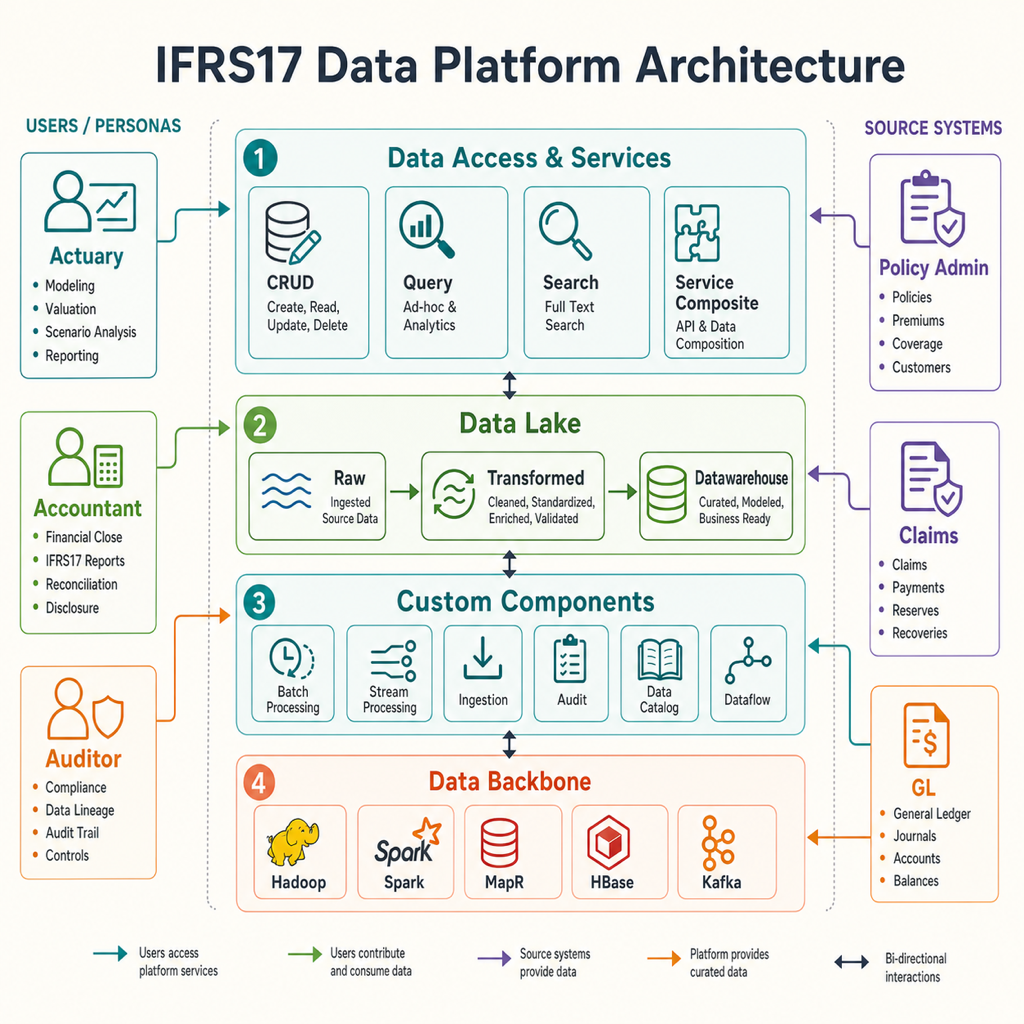
Quatre couches séparent la logique comptable des systèmes distribués
L'application Java/Angular reposait sur quatre couches : API de service, lac de données en trois zones, composants de traitement partagés et socle distribué. Stabiliser les interfaces entre les couches 1 et 4 nous a pris six mois. À l'époque, ce travail semblait nous ralentir. Ces interfaces nous ont ensuite permis de remplacer MapR par Hadoop sans modifier les calculs.
SCHÉMAArchitecture en quatre couches de la plateforme IFRS17
Les quatre couches, du haut vers le bas
1. Accès aux données et services
Expose les couches inférieures sous forme d’API REST à l’application web Java/Angular.
Modèle de services composites : services CRUD, de requête et de recherche.
Un contrat stable pour l’interface. Le stockage et le moteur peuvent évoluer sans perturber le travail de l’actuaire.
2. Lac de données
Stockage en trois zones : arrivée des données brutes, données transformées, entrepôt de données.
Données brutes (historique immuable), données transformées (nettoyées et conformes), entrepôt de données (résultats actuariels prêts pour le reporting).
Historisation nécessaire à l’audit. Pour reproduire une clôture du troisième trimestre 2024, nous repartons des données brutes au lieu de corriger les tables en production.
3. Composants sur mesure
Des outils partagés pour l’ingestion, le traitement, l’audit et l’accès aux données.
Traitements par lots et en flux, ingestion par lots et en flux, suivi d’audit, catalogue et contrôle des données, gestion des flux, exposition des données.
Les équipes réutilisent l’infrastructure pour de nouveaux cas actuariels. Nous avons livré les composants génériques d’ingestion en premier.
Les jointures sur 200 millions de lignes s’exécutent ici. Les actuaires voient des tableaux proches d’Excel, pas les partitions qui les produisent.
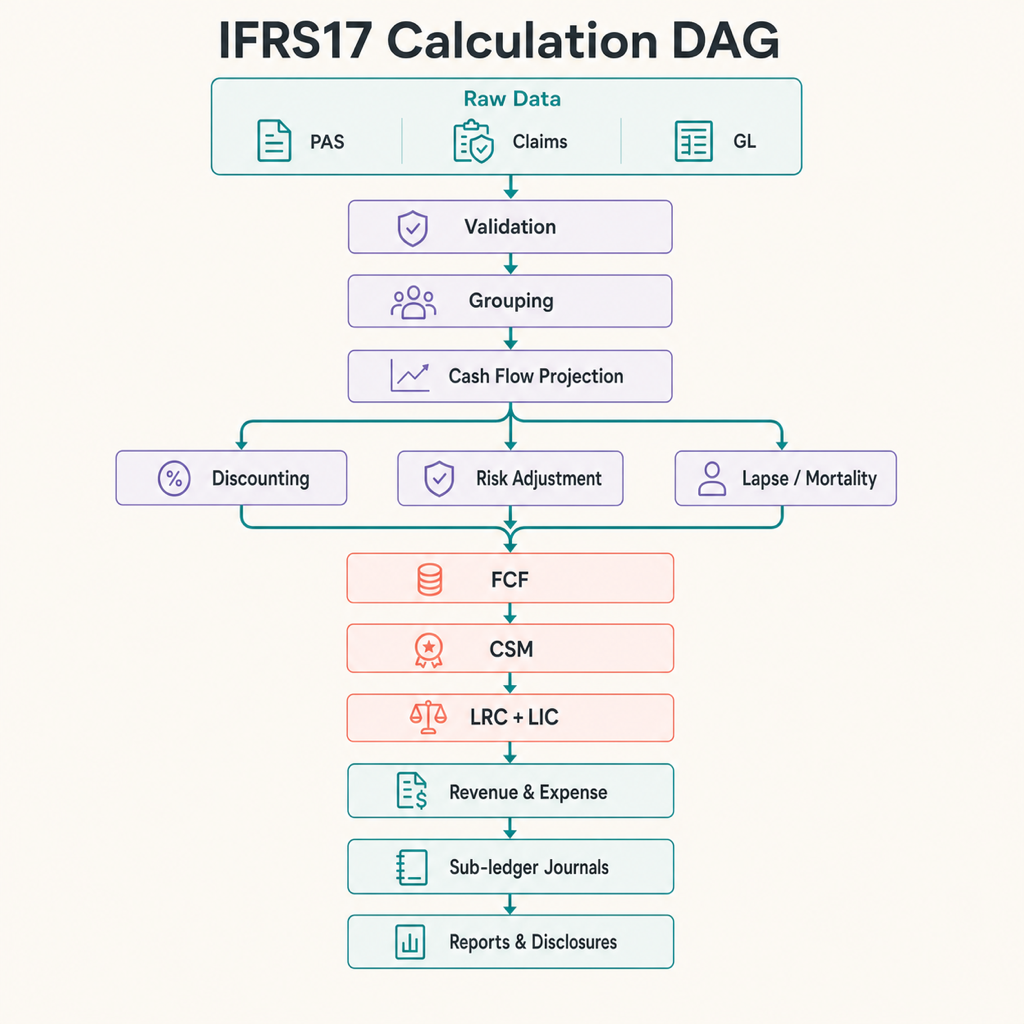
SCHÉMADépendances entre les dix étapes de calcul
Dix étapes, des données brutes aux états réglementaires
L’ordre des dépendances est strict. Aucune étape ne peut ignorer un calcul amont, car les informations publiées au titre d’IFRS17 doivent pouvoir être rapprochées jusqu’à la projection initiale des flux de trésorerie.
1
Ingestion et validation des données
Extractions du progiciel de gestion des contrats, flux de sinistres et positions d’actifs. Le système vérifie le schéma, l’intégrité référentielle et les règles métier avant toute entrée dans le lac de données.
2
Regroupement des contrats
Portefeuille → catégorie de rentabilité → cohorte annuelle. La règle selon laquelle aucun groupe ne couvre des contrats espacés de plus de 12 mois détermine toute la stratégie de partitionnement.
3
Projection des flux de trésorerie par groupe
Appliquer le modèle actuariel : projeter primes, sinistres, frais période par période sur l'horizon du contrat.
4.1
Actualisation
Appliquer la courbe d'actualisation conforme retenue pour le déploiement. Cette implémentation européenne partait des données sans risque EIOPA avec un ajustement d'illiquidité documenté.
4.2
Ajustement pour risque
Soit une agrégation du coût du capital du SCR, soit une VaR/CTE appliquée à la distribution du passif.
4.3
Application des hypothèses de rachat / mortalité
Multiplier les flux projetés par les facteurs de survie, mortalité et rachat, la couche comportementale et biométrique.
5
FCF = VA(CF) + RA
Combiner les flux actualisés avec l’ajustement pour risque. Un FCF négatif indique un groupe rentable ; un FCF positif, un groupe déficitaire.
6
Calcul de la CSM
CSM initiale = −FCF₀ pour les groupes rentables. Les périodes suivantes suivent le tableau de variation : intérêts, affaires nouvelles, changements d’estimations et amortissement.
7
Assemblage de la LRC et de la LIC
LRC = FCF_RC + CSM. LIC = BEL_IC + RA_IC. Ces deux éléments composent le passif d’assurance.
8
Comptabilisation des produits et charges
Calculer l’IR à partir de l’amortissement de la CSM, de la libération du RA et des sinistres attendus libérés. Calculer l’ISE à partir des sinistres survenus et des pertes sur les groupes déficitaires.
9
Écritures de journal au sous-livre
Traduire les mouvements IFRS17 en écritures comptables que le grand livre peut comptabiliser sans surprise.
10
Reporting et informations à fournir
Bilan, P&L, analyse des variations et tableaux de variation CSM/RA/LRC/LIC. Chaque résultat doit pouvoir être rapproché jusqu’à l’étape 1.
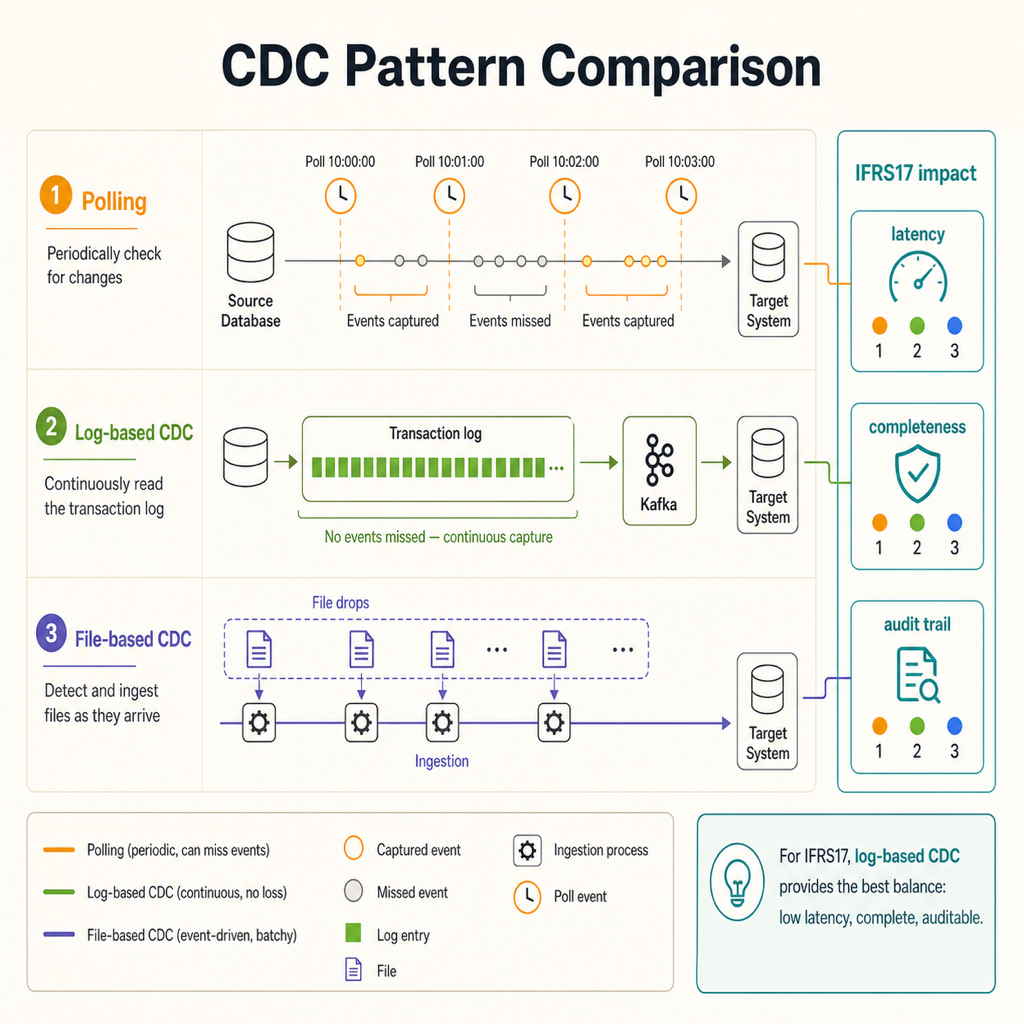
SÉQUENCEComparaison de trois modes de capture des changements
Trois modes de capture des changements pour les données actuarielles
Interrogation périodique
Rechercher les changements à intervalles réguliers. Selon l’historique disponible et la méthode d’interrogation, des changements intermédiaires peuvent être manqués ; les scans ajoutent aussi des entrées-sorties.
Lecture des journaux
Lire les journaux de transactions lorsque la source fournit des changements complets et ordonnés. Cette approche est efficace, mais ne convient pas à toutes les sources actuarielles.
Surveillance de fichiers
Surveiller le système de fichiers pour détecter les dépôts actuariels. Kafka Connect FilePulse prend en charge le mode de dépôt réellement utilisé par les actuaires.
Information réglementaire
Autorité
Périmètre
Rôle principal
ACPR
France
Supervision française et doctrine applicable au marché national
EIOPA
Union européenne
Supervision et information prudentielle européennes ; rôle distinct de la normalisation IFRS
IFRS Foundation
International
Élaboration de la norme et publication de la documentation officielle IFRS17
04 · INCIDENTS DE PRODUCTION
Cinq incidents de production ont façonné la plateforme
La table de faits principale contenait 200 millions de contrats et rejoignait chaque nuit les tables de référence. Les changements arrivaient par CDC depuis le progiciel de gestion des contrats. Spark exécutait les calculs, Kafka transportait les événements, MapR stockait les données et Hadoop YARN gérait le cluster. Je pensais consacrer l'essentiel de mon temps aux calculs IFRS17. Ce sont finalement ces cinq problèmes de production qui l'ont occupé.
A. Ingestion CDC de 200 millions de lignes arrivées dans le désordre
Problème
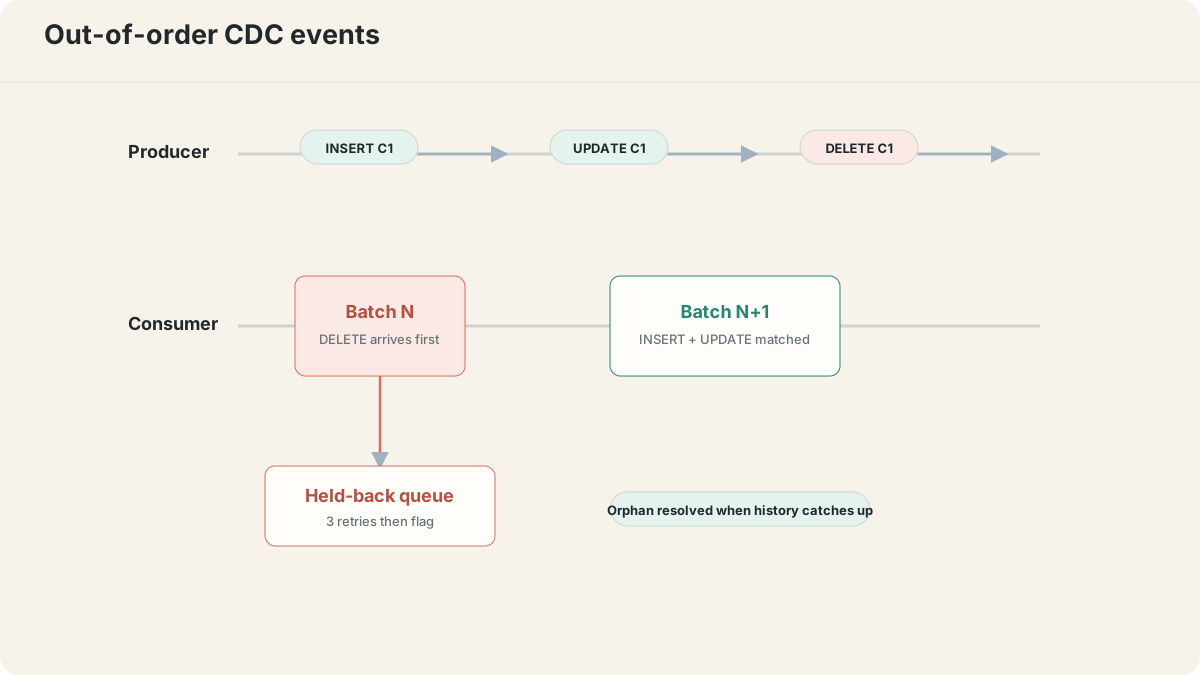
Le flux CDC issu du progiciel de gestion des contrats livrait parfois les événements dans le désordre entre deux micro-lots. La suppression d'un contrat pouvait arriver dans le lot N, tandis que l'insertion et la mise à jour correspondantes attendaient encore dans le lot N+1. En appliquant ces opérations telles quelles, le système tentait de supprimer une ligne qui n'existait pas encore. Il créait alors un orphelin silencieux et faussait les calculs de provision en aval.
Cause racine
Le producteur ordonnait les événements par partition, mais notre consommateur appliquait les modifications par micro-lots temporels. Le tri par horodatage dans un lot ne résolvait pas les dépendances envers un événement situé dans un autre lot. C'est l'incident observé ; cela ne signifie pas que Kafka réordonnait les messages dans une partition.
Correction
J'ai ajouté un contrôle des orphelins avant l'application de chaque modification. Tout événement dont le parent manquait dans l'entrepôt rejoignait une file d'attente dans l'espace temporaire HDFS. Au lot suivant, nous le comparions de nouveau aux données fraîchement appliquées. Après trois tentatives, le système signalait l'anomalie.
Effet mesuré
Le taux d'orphelins observé est passé d'environ 0,4 % à zéro. Les sollicitations du week-end pour des contrats manquants ont cessé.
SÉQUENCEÉvénements CDC désordonnés : suppression avant insertion
B. Explosion des lignes contrat-mois et saturation de la mémoire
Problème
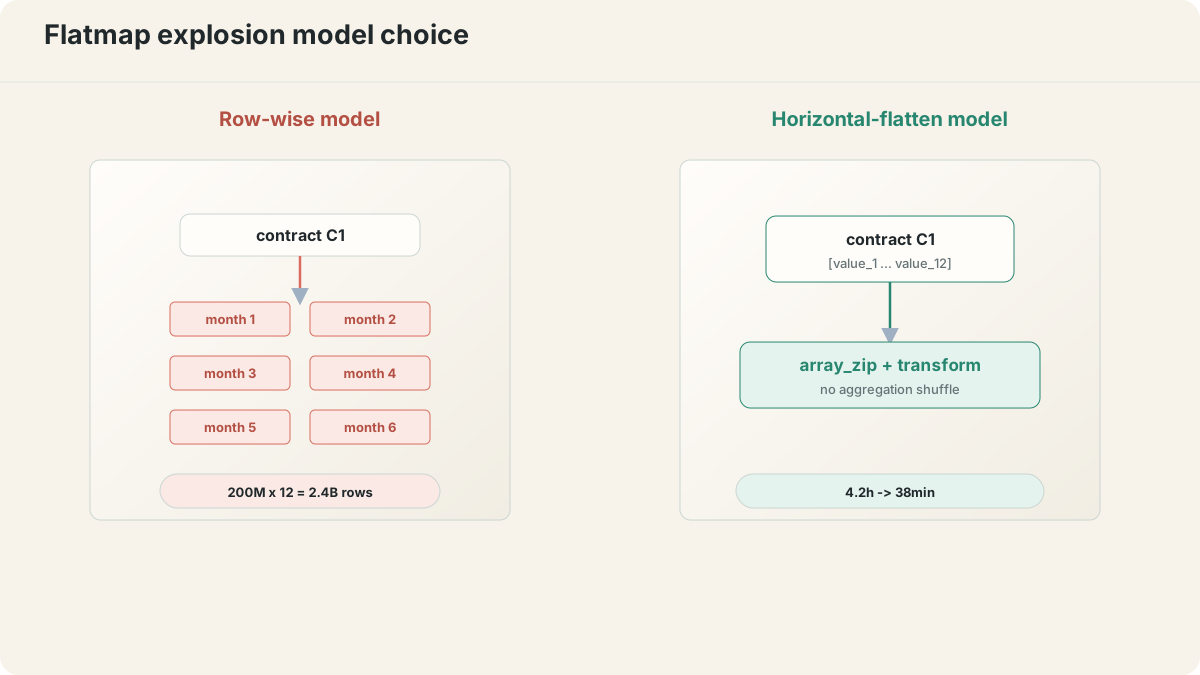
Chaque contrat devait être projeté sur les mois restants pour calculer les flux. Le modèle intuitif, une ligne par contrat et par mois, transformait 200 millions de contrats en 2,4 milliards de lignes sur 12 mois. Un partitionnement naïf par contract_id provoquait ensuite un brassage massif lors du groupBy. Un seul exécuteur finissait par saturer sa mémoire en traitant un groupe de contrats surreprésenté.
Cause racine
Dans ce traitement, transformer les périodes en lignes alourdissait les redistributions pour les agrégations par période et les fonctions de fenêtrage suivantes.
Correction
Nous avons conservé une ligne par contrat et stocké le vecteur mensuel dans une colonne de type tableau. Les fonctions de fenêtrage sont devenues des opérations array_zip et transform. Nous repartitionnions une fois avec hash(contract_id) % N, puis écrivions dans une table distribuée en compartiments et triée par (contract_id, period_start). Les étapes suivantes compatibles pouvaient réutiliser ce partitionnement au lieu de répéter la redistribution.
Effet mesuré
Le traitement par contrat est passé de 4,2 heures à 38 minutes. La pression mémoire sur les exécuteurs a suffisamment baissé pour réduire la taille du cluster d'un tiers.
SCHÉMAExplosion des lignes : modèle vertical ou tableau horizontal
C. Redistribuer 200 millions de lignes pour chaque fenêtre glissante
Problème
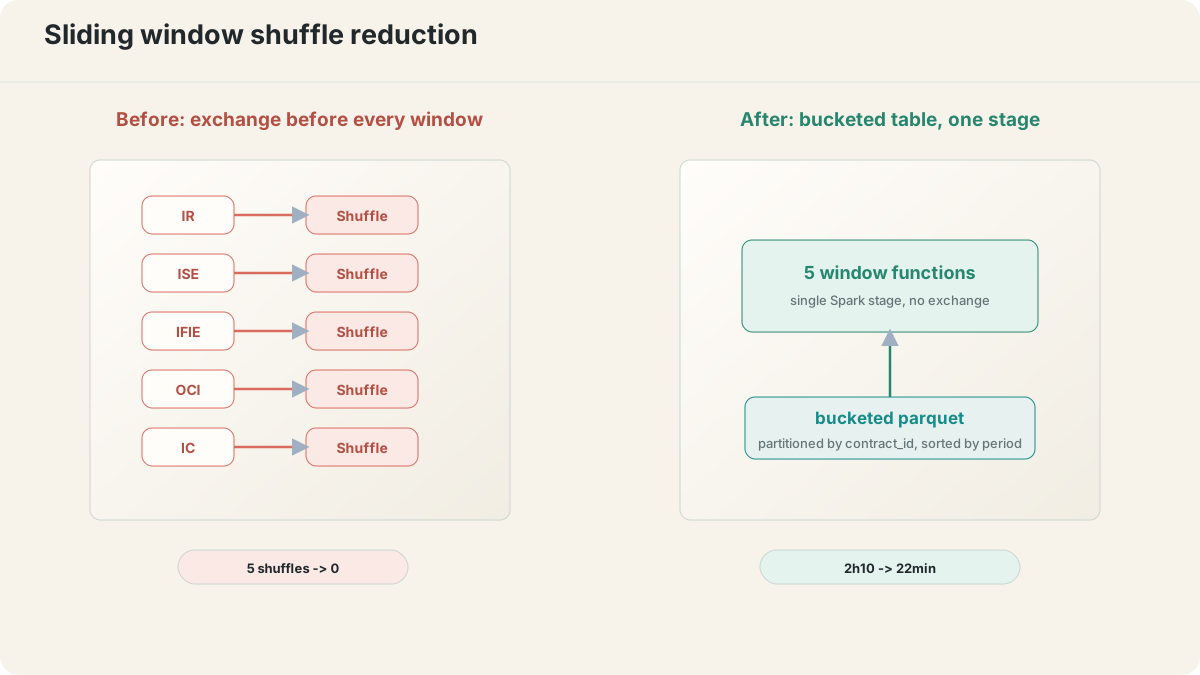
Les formules de provisionnement utilisaient des fenêtres glissantes par contrat sur les périodes de développement. URR = max(UPR − DAC, UEC). IBNR = Sinistres ultimes − Payés − Provisions dossier, calculé à chaque date d'arrêté. Avec le partitionnement Spark par défaut, le graphe de calcul redistribuait toute la table pour chaque indicateur. Cinq indicateurs entraînaient donc cinq redistributions complètes de 200 millions de lignes.
Cause racine
Nos définitions de fenêtres exigeaient un partitionnement et un ordre absents du DataFrame d'entrée. Les plans d'exécution ajoutaient des échanges et des tris répétés.
Correction
Nous avons prépartitionné les données par contract_id et les avons triées par (contract_id, period) à l'écriture dans des tables distribuées en compartiments. Dans ce déploiement, les fenêtres compatibles partageaient ensuite une étape. Catalyst supprimait l'échange lorsqu'il pouvait réutiliser les métadonnées de partitionnement.
Effet mesuré
La suite de provisionnement, composée de cinq indicateurs, est passée de 2 h 10 à 22 minutes. Cette correction a permis à l'ensemble du cycle de tenir l'objectif d'une heure.
SCHÉMAFenêtres glissantes : avant et après le prépartitionnement
D. Jointures asymétriques sur de petites tables de référence
Problème
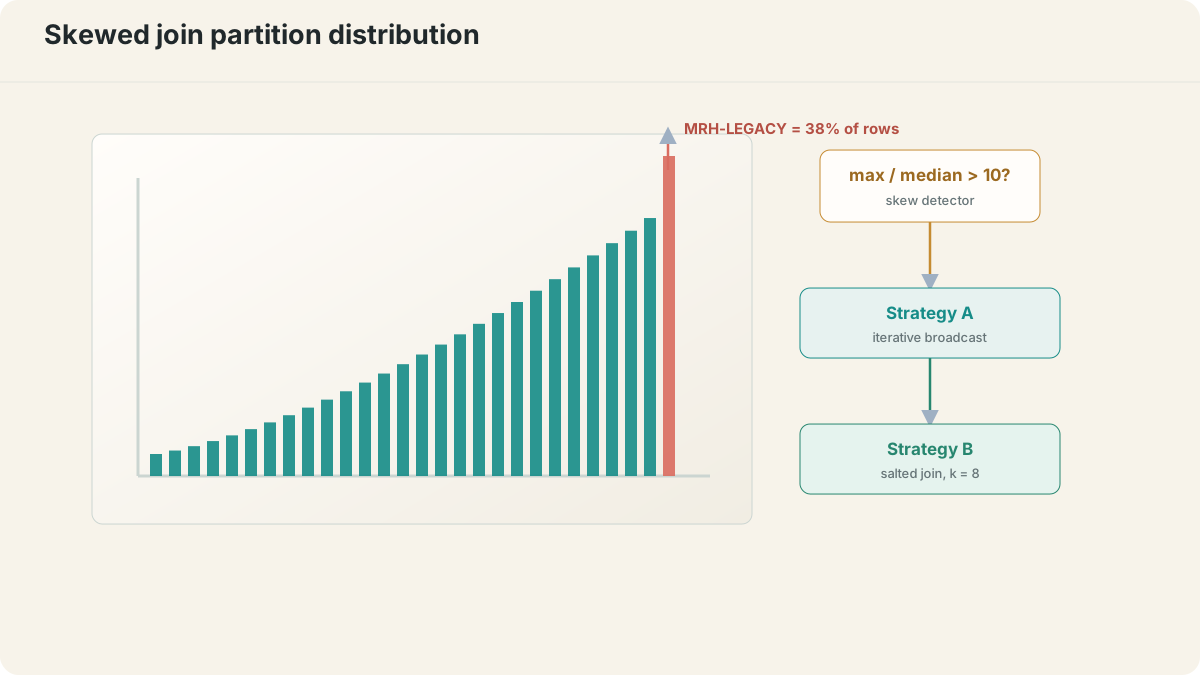
La table de référence des produits comptait 1 200 codes. Un seul, celui d'un ancien produit multirisque habitation, représentait 38 % des lignes de faits. La jointure envoyait ces 38 % vers un même exécuteur, qui saturait systématiquement sa mémoire.
Cause racine
Le hachage plaçait les lignes du code produit dominant dans la même partition. Notre configuration Spark ne divisait pas cette partition déséquilibrée.
Correction
J'ai construit un détecteur de déséquilibre qui calculait le nombre de valeurs distinctes et une estimation des percentiles sur les clés de partition avant chaque jointure importante. Lorsque le rapport entre la plus grande partition et la médiane dépassait 10, le système changeait de stratégie. Première option : diffuser progressivement la petite table. En solution de repli, nous ajoutions une clé aléatoire dans [0, k) au grand côté, dupliquions k fois le petit côté, réalisions la jointure, puis supprimions cette clé.
Effet mesuré
Les saturations mémoire répétées sur cette jointure ont cessé. Plus tard dans l'année, le détecteur a repéré deux autres jointures déséquilibrées que personne n'avait encore identifiées.
GRAPHIQUEJointure déséquilibrée : distribution des partitions
E. Publication atomique et retour arrière sur MapR
Problème
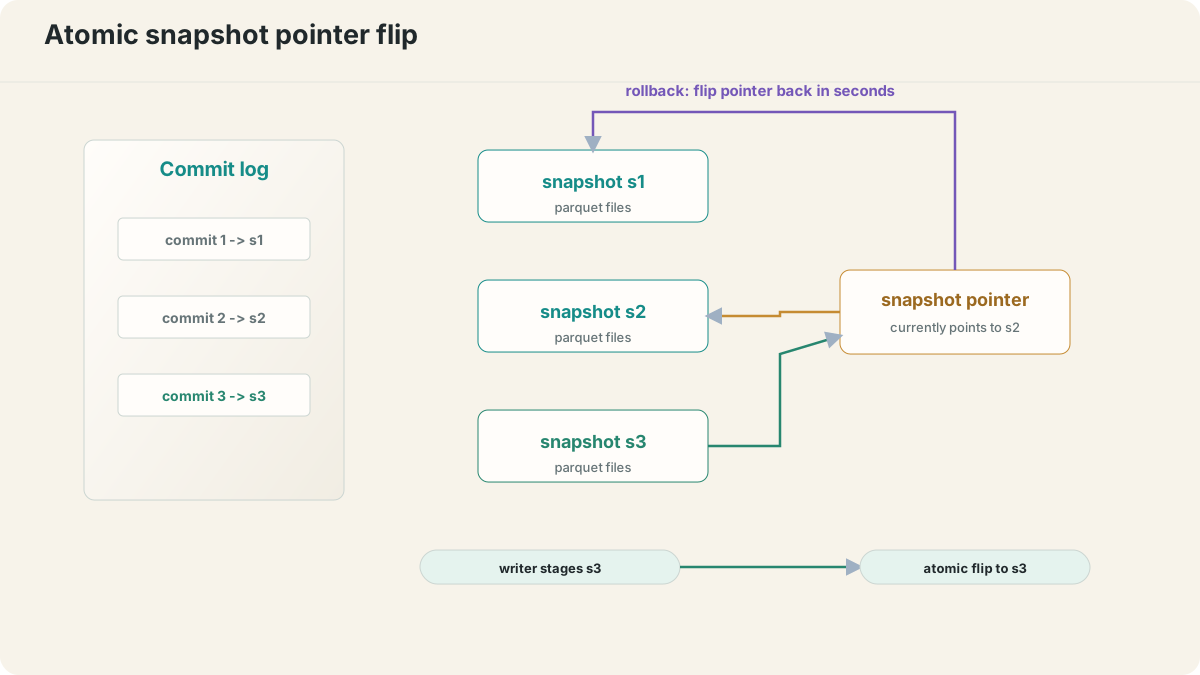
Les actuaires relançaient souvent les calculs. Lorsqu'un paramètre changeait à la clôture mensuelle, ils rejouaient les 90 derniers jours. Il nous fallait des validations atomiques : soit le rejeu remplaçait entièrement la version précédente, soit rien ne changeait. Il fallait aussi une API fiable pour revenir en arrière lorsqu'un rejeu était incorrect. Delta Lake existait déjà, mais n'était pas encore suffisamment mûr pour la production sur MapR FS.
Cause racine
Notre traitement Parquet n'avait pas de protocole de validation au niveau de la table. Une écriture partielle pouvait exposer un mélange d'anciennes et de nouvelles données.
Correction
J'ai construit une boîte à outils de gestion des flux : journal de validation en ajout seul par table logique, petit fichier pointant vers l'instantané courant et basculé atomiquement, historique conservé N jours et API manuelle de retour arrière. Les lecteurs passaient par le pointeur ; les écritures étaient préparées dans un nouveau répertoire d'instantané. Le retour arrière prenait quelques secondes. Ce récit décrit la publication, pas une preuve de conformité ACID complète face aux écritures concurrentes ou à tous les scénarios d'arrêt.
Effet mesuré
Les actuaires ont effectué plus de 40 rejeux par trimestre sans incident de lecture partielle signalé. Nous avons documenté le mécanisme sur le Confluence interne ; trois autres équipes l'ont adopté.
SCHÉMABascule atomique du pointeur d’instantané
GRAPHIQUEDurée du cycle de provisionnement avant et après la plateforme
Les chiffres qui ont compté pour l’activité
Cycle de provisionnement en production
7 heures
→
1 heure
Incidents de qualité des données sur 90 jours glissants après le lancement du catalogue
référence initiale
→
−40 %
Cadence de livraison des équipes après les composants génériques d'ingestion
référence initiale
→
2× plus rapide
Intégration d'un nouveau cas d'usage actuariel
semaines
→
jours
05 · SPARK + KAFKA
Les modèles Spark qui ont ramené le cycle à une heure
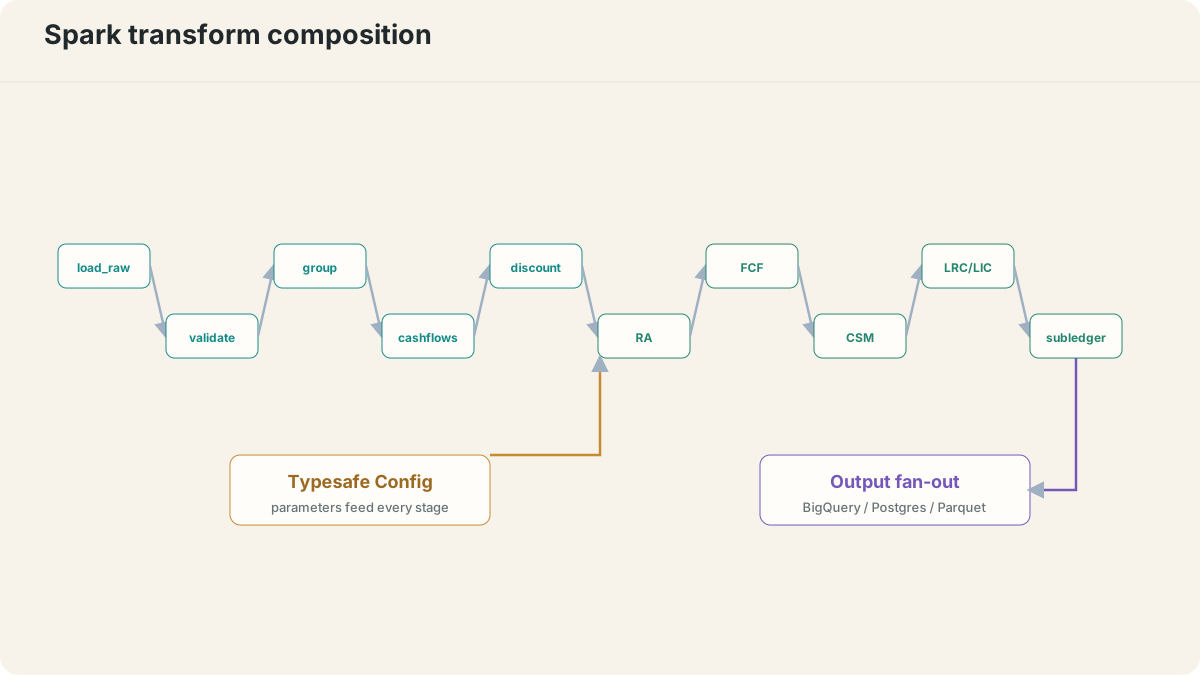
Nous remplacions SAS et MapR par PySpark, Kafka et Hadoop dans ce déploiement. Les équipes avaient besoin d'une structure de traitement réutilisable en plus d'un nouveau moteur. Trois modèles de conception couvraient l'essentiel de ce besoin.
SCHÉMAComposition des transformations Spark pour IFRS17
Cadres de développement des traitements Spark
ETL orchestré
Une organisation inspirée de MVC. Nous avons sorti la logique ETL des notebooks pour la placer dans des bibliothèques Python réutilisables. Une interface fluide permettait de composer des graphes de traitements complexes.
Transformations composables
L’enchaînement de PySpark DataFrame.transform() produisait des traitements modulaires. Chaque calcul IFRS17 devenait une fonction réutilisable.
Applications configurables
Typesafe Config séparait la logique métier de l’environnement. Le même fichier JAR fonctionnait en développement, en recette et en production, sans modification du code.
Décisions technologiques
Domaine
Technologie
Motif du choix
CDC
MapR-DB CDC API / StreamSets
Capture native, en temps réel, des changements du traitement actuariel
Orchestration
Airflow / Dagster / Oozie
Airflow pour les graphes Python, Dagster pour la qualité des données, Oozie pour l’intégration Hadoop
Qualité des données
Deequ (Amazon)
Tests automatisés d’exactitude, de complétude et de cohérence
Sérialisation
Avro (ingestion) → Parquet (stockage)
Avro pour les écritures en flux, Parquet pour les analyses intensives en lecture
Migration
hadoop distcp
Outil standard de migration des données de MapR-FS vers HDFS
Sécurité
Kerberos
Authentification du cluster Hadoop et Spark
Migration SAS → Spark
Cas EXL
EXL annonce une amélioration de 50 % de l’efficacité de migration du code SAS vers PySpark chez un assureur. C’est un résultat de migration rapporté par le prestataire, pas une accélération de 50 % des traitements Spark.
Allianz UK sur Databricks
Le témoignage client lié décrit le passage d’Allianz UK Personal Lines de SAS au Lakehouse de Databricks. Ce projet distinct ne prouve pas les résultats de notre plateforme.
Conversion assistée par IA chez Hexaware
Hexaware décrit la conversion automatisée de SAS vers PySpark et annonce des taux de précision initiale. Ces chiffres ne déterminent pas la part de logique actuarielle que l’on peut migrer sans revue.
06 · DÉMONSTRATEUR À COÛT NUL
Reproduire le flux de calcul sans données de production
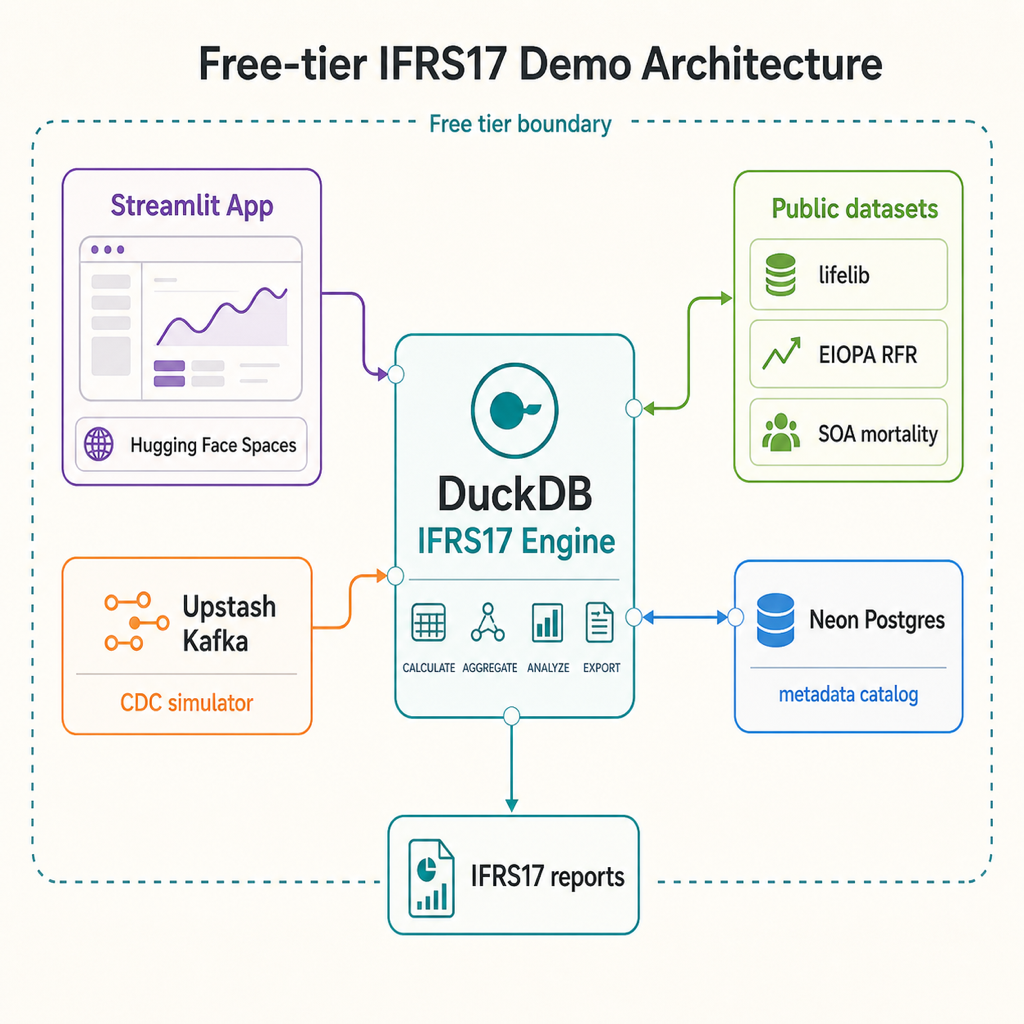
Cette architecture pédagogique utilise DuckDB pour les calculs, Streamlit pour l'interface, un flux léger pour simuler le CDC et Postgres pour les métadonnées. Elle vise à explorer le flux sans données clients de production. Vérifiez les limites des offres gratuites avant de les utiliser. Ce n'est pas un moteur IFRS17 validé ; elle ne fournit ni les contrôles de production, ni les rapprochements, ni la sécurité, ni la gouvernance de clôture.
SCHÉMAArchitecture du démonstrateur IFRS17 à coût nul
Composant
Outil
Coût
Atouts
Moteur de calcul
DuckDB
Gratuit
OLAP rapide dans le processus, licence MIT, intégration Python
Application web
Streamlit / Gradio
Gratuit
Hébergement gratuit sur Hugging Face Spaces
Simulation CDC
Upstash Kafka
Offre gratuite
Service sans serveur, facturation à la requête et API REST
Catalogue de métadonnées
Supabase / Neon
Offre gratuite
PostgreSQL administré, environ 500 Mo et branches de base
07 · ORGANISATION
Partager la plateforme entre soixante ingénieurs
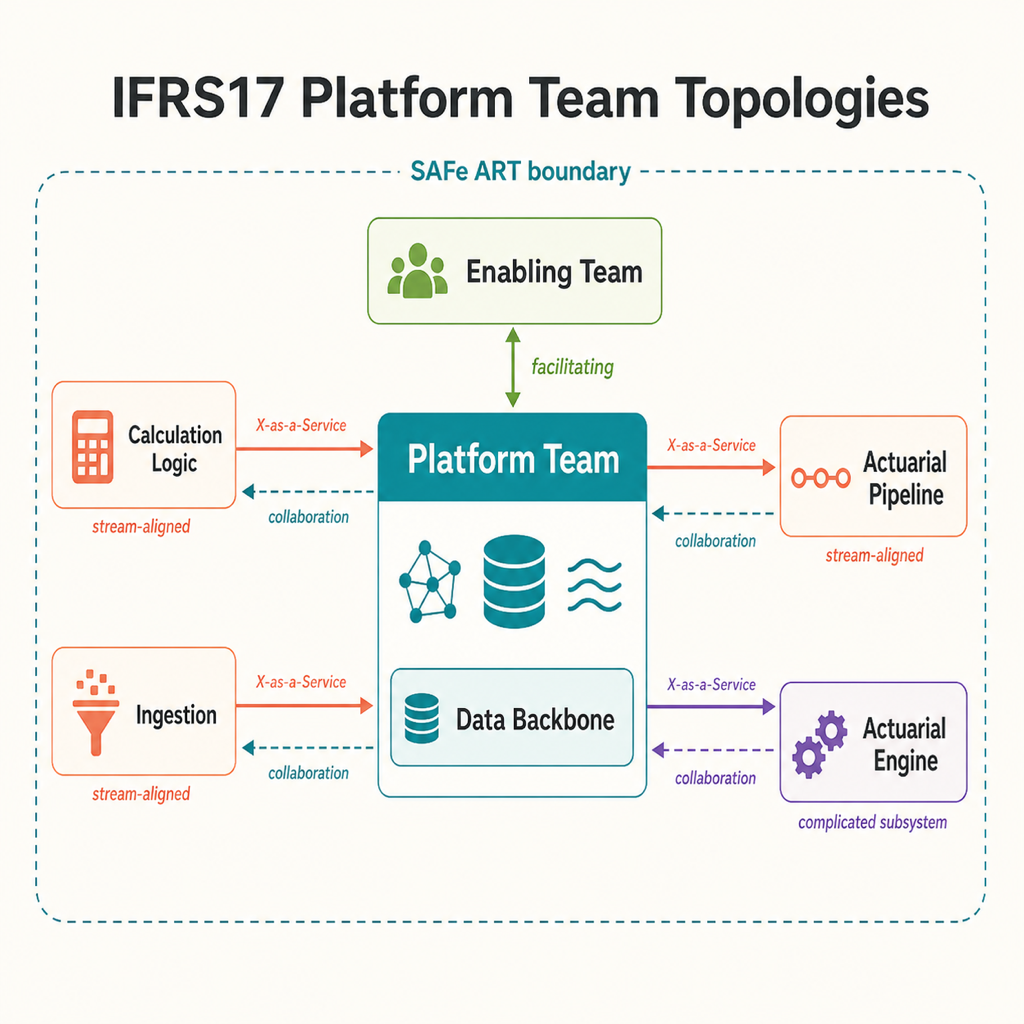
Plus de 60 ingénieurs répartis dans 10 équipes travaillaient sur la plateforme. Nous avons appliqué Team Topologies aux trains de livraison SAFe pour répartir les responsabilités entre infrastructure partagée, calculs actuariels et ingestion.
SCHÉMAOrganisation de 60 ingénieurs autour de la plateforme IFRS17
Team Topologies appliqué à une plateforme de données
Équipe plateforme
Responsable du socle de données, de Spark, de Kafka et de MapR/Hadoop. Elle fournit une base stable aux autres équipes et réduit leur charge cognitive.
Équipe alignée sur un flux de valeur
Alignée sur un domaine tel que le calcul IFRS17, l’ingestion ou le traitement actuariel. Elle en assume la responsabilité de bout en bout.
Équipe facilitatrice
Elle diffuse de nouvelles technologies et pratiques : modélisation avancée des données, fonctions récentes de la plateforme et accompagnement du Data Mesh.
Équipe de sous-système complexe
Elle réunit les spécialistes des composants exigeant une expertise pointue, comme le moteur de calcul actuariel ou les modules de conformité réglementaire.
Métriques de succès IDP
Catégorie
Indicateurs clés
Adoption
Utilisateurs actifs quotidiens, part des déploiements réalisés via la plateforme
Expérience développeur
NPS développeur, productivité perçue
Vitesse de livraison
Indicateurs DORA : délai de livraison et fréquence de déploiement
Fiabilité
Taux d’échec des changements, temps moyen de rétablissement
Efficacité
Utilisation des ressources et maîtrise des coûts cloud
Études de cas d’ingénierie de plateforme
Compagnie d'assurance (Microsoft)
Un exemple externe de regroupement des parcours de développement au sein d’une plateforme interne fondée sur Backstage.
Institution financière
Un exemple externe de modèles d’ingestion et de parcours de développement communs. La réduction annoncée de plusieurs mois à quelques jours demande une source nommée avant de servir de comparaison.
Intégration Data Mesh
Le modèle ThoughtWorks associe Team Topologies et Data Mesh. Les équipes alignées sur les flux de valeur sont responsables de leurs produits de données, comme le produit actuariel IFRS17. Un responsable produit, un ingénieur des données et un analyste forment le trio produit.
08 · BILAN
Ce que je conserverais et ce que je remplacerais
Après 18 mois, je conserverais les composants d'ingestion partagés et les adaptateurs de stockage. J'avancerais les contrôles de rejeu dans le calendrier et consacrerais moins de temps à maintenir une couche de tables sur mesure.
Trois choses que je referais à l'identique
Construire le socle de données avant le moteur de calcul.
Les trois premiers sprints ont porté sur les traitements par lots, l'ingestion et l'audit, sans logique IFRS17. Cela semblait lent. Les équipes suivantes ont pu réutiliser ces composants et démarrer en quelques jours.
Masquer MapR derrière des adaptateurs génériques dès le premier jour.
Après l'annonce de fin de vie de MapR FS, notre passage à Hadoop a pris quatre semaines. J'estimais le travail sans adaptateurs à quatre trimestres ; cette comparaison n'a pas été testée.
Traiter les actuaires comme des utilisateurs, pas comme de simples consommateurs.
Nous organisions une réunion hebdomadaire avec l'équipe de provisionnement et rédigions une RFC pour chaque changement affectant la clôture. Le taux de retours pour correction a baissé d'environ 60 % en six mois.
Deux choses que je referais autrement
Livrer la boîte à outils de gestion des flux au sprint 1, pas au sprint 12.
Le journal de validation associé à un pointeur d'instantané nous a sauvés en production. Nous l'avons construit parce que Delta Lake n'était pas encore adapté à MapR FS, mais seulement après que les premiers rejeux eurent commencé à corrompre les données. Ce mécanisme aurait dû être notre premier livrable.
Adopter Iceberg ou Delta dès que la plateforme l'a permis.
Notre boîte à outils répondait au besoin initial. Deux ans plus tard, les formats de table libres avaient rattrapé leur retard et notre couche interne était devenue coûteuse à maintenir. En sortir nous a finalement coûté plus cher que la construire.
La question que je n'ai jamais complètement résolue
Comment garantir un rejeu déterministe lorsque les actuaires modifient leurs hypothèses en cours de clôture ? Nous conservions l'historique des instantanés, pouvions revenir à une version antérieure et relancer les calculs depuis les données brutes. Pourtant, si un actuaire ajustait la courbe de rachat à 16 h le troisième jour de clôture, les données amont avaient déjà évolué. Nous figions les données d'entrée au début de la clôture, ce qui ne faisait que masquer le problème : la clôture actuarielle et les flux en direct sont fondamentalement décalés. Depuis, j'ai retrouvé cette difficulté chez trois autres assureurs. Je n'ai toujours pas trouvé de solution pleinement satisfaisante.