« Où est mon paiement ? »
Une seule trace dans 11 pays
Un paiement transfrontalier quittait une banque, traversait plusieurs intermédiaires et produisait des statuts dans des systèmes gérés par différentes équipes. J’ai travaillé sur la couche de données commune qui a transformé ces fragments en un parcours temps réel couvrant 200 corridors.
Un paiement d’entreprise traversait plusieurs banques et plusieurs frontières. Au moindre retard, répondre à la question « Où en est mon paiement ? » obligeait à recouper des messages dispersés dans les systèmes locaux et auprès des équipes opérationnelles de 11 pays.
J’ai travaillé sur la couche de données qui réunissait ces événements en une chronologie unique, couvrant 200 corridors de paiement. Les équipes opérationnelles pouvaient ainsi analyser une anomalie à partir de la même trace que celle présentée au client.
L’étude de cas en 60 secondes
Suivre un paiement dans des systèmes séparés
Un paiement transfrontalier ne se résume pas à la mise à jour d’un enregistrement. La banque émettrice transmet une instruction, les banques correspondantes exécutent chacune leur étape, les contrôles de conformité peuvent interrompre le traitement, des frais sont parfois prélevés, puis la banque bénéficiaire confirme le crédit. Chaque participant ne voit qu’une partie du parcours.
SWIFT gpi fournit le fil conducteur : l’Unique End-to-End Transaction Reference, ou UETR. Notre enjeu consistait à conserver cet identifiant lorsque les événements provenaient de pays et de systèmes différents, puis à en tirer une chronologie suffisamment fiable pour les équipes opérationnelles.
Une trace devait répondre à quatre questions
Afficher le dernier état confirmé sans effacer les événements qui l’ont précédé.
Mesurer séparément chaque étape afin de distinguer un corridor lent, un contrôle de conformité et un délai imputable à la banque destinataire.
Conserver les frais et la devise de chaque étape, pas uniquement le montant finalement crédité.
Fournir aux équipes opérationnelles le détail nécessaire au diagnostic, tout en présentant au client un historique plus simple et maîtrisé.
Construire un historique d’événements, pas un simple statut modifiable
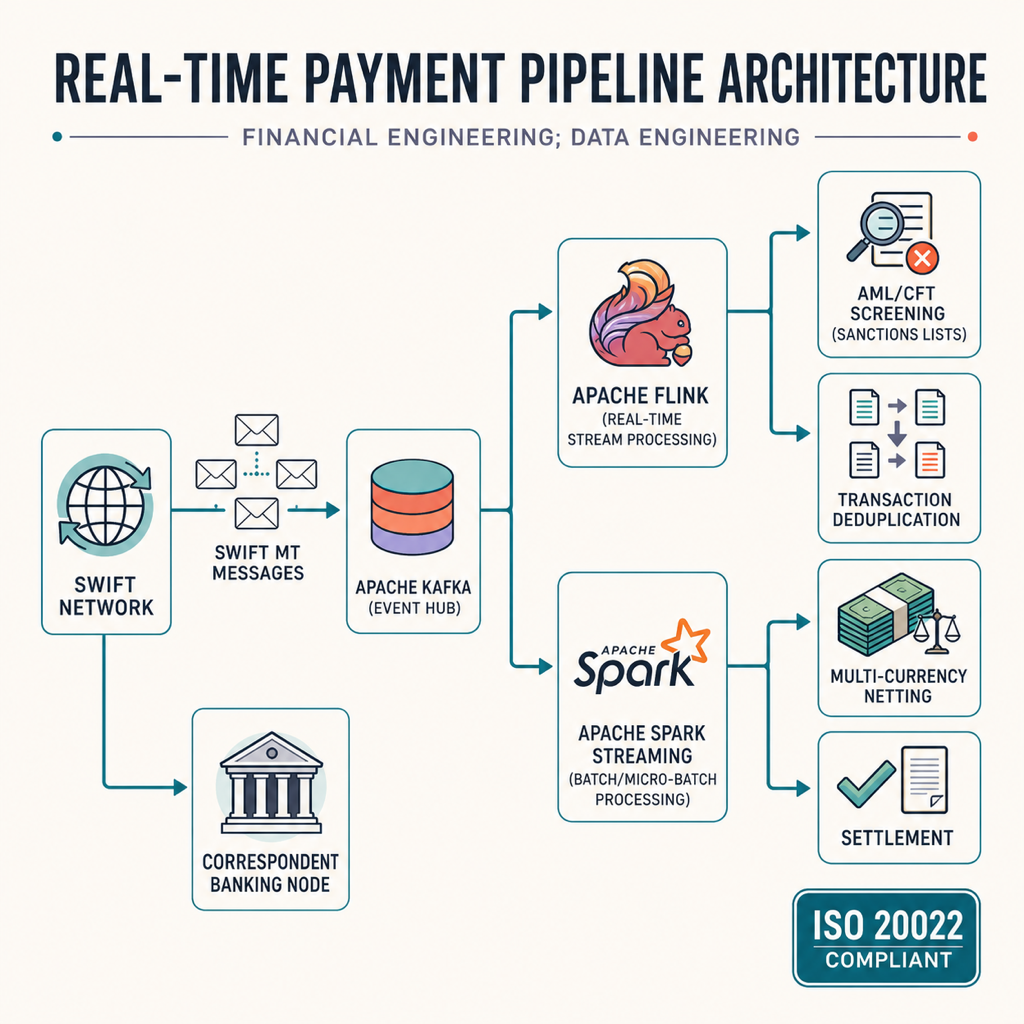
L’unité de base était un événement de paiement associé à l’UETR : statut, horodatage, participant, corridor et informations disponibles pour cette étape. Kafka transportait les mises à jour ; Spark constituait l’historique consolidé et les vues utilisées par les applications de suivi.
La décision essentielle fut de conserver chaque événement. Si un nouveau statut écrase le précédent, le tableau de bord sait dire où se trouve le paiement, mais pas comment il y est arrivé. Un historique ordonné répond à la fois au besoin de suivi immédiat et aux enquêtes ultérieures.
Les paiements sans incident n’étaient pas le vrai défi
Ce qui a changé pour ceux qui suivaient le paiement
Les opérations et les clients consultent désormais le même historique consolidé. Les opérations conservent le détail banque par banque pour examiner les anomalies ; le client voit le statut de suivi correspondant.
Trois règles de conception se sont imposées
Si une transformation interne perd l’identifiant de bout en bout, la trace redevient un ensemble d’enregistrements locaux.
Le statut courant répond au client. L’historique sert aux opérations, à l’audit et à l’analyse des incidents.
Le niveau de détail diffère, mais les deux vues ne doivent jamais se contredire sur le parcours du paiement.
Ce que cette étude de cas ne prétend pas
Le client reste anonyme. Les 11 pays et 200 corridors décrivent le périmètre du projet, pas son débit ni sa latence. Aucun montant de paiement, volume de messages, percentile de latence ou recul mesuré des demandes d’assistance n’est publié ici. Les références Swift expliquent le service ; elles ne vérifient pas ce déploiement de façon indépendante.